الفريق العربي للبرمجةأرشيف المنتديات · 2000 – 2023
نسخة أرشيفية للقراءة فقط — التسجيل والمشاركة مغلقان، والمحتوى محفوظ كما كان.

نقاش : هل عملية الضرب mul بطيئة بالفعل !

بدأه مصطفى 36a2 في 5 نوفمبر 2013 · 8 رد · 919 مشاهدة · في لغة C و ++C
مشاركة: واتساب X فيسبوك تيليجرام
#1 صاحب الموضوع

السلام عليكم ورحمة الله وبركاته
كثيراً ما نسمع في الأسمبلي أن عملية الضرب mul بطيئة ..
سنناقش اليوم بإذن الله صحة هذا القول ..
سنقارن أولا الضرب ب4 والذي يقابل الإزاحة المنطقية للعدد ب2 لليسار
في الكود التالي قمت بمقارنة الوقت اللزم للقيام بمليار عملية ضرب ومليار عملية إزاحة منطقية لليسار
(توجد بعض التعليمات للتحكم أيضاً .. (الكود على Visual C++8 )
لنبدأ :

#include<stdio.h>
#include<windows.h>
int main()
{
    int a=GetTickCount();
        _asm{
            mov ecx,1000000000
go:
            mov eax,15
            mov ebx,4

            mul ebx//تعليمة الضرب

            loop go
        }
    int b=GetTickCount();
        _asm{
            mov ecx,1000000000
go2:
            mov eax,15
            mov ebx,4

            shl eax,2//تعليمة الإزاحة
            

            loop go2
        }
    int c=GetTickCount();
    printf("mul=%i\nshl=%i\n",b-a,c-b);
    return 0;
}
شغّل البرنامج واكتشف الفرق :)
الإزاحة أسرع من الضرب بحوالي 1622 ميللي ثانية .. في مليار عملية أي من أجل عملية واحدة 0.000001622 ميللي ثانية .. هو الفرق بين السرعتين !!
والآن لنجرّب الضرب بــ 5 ..
نحتاج للضرب ب5 إلى الضرب ب4 ثم إضافة العدد .. مثلا 8*5 هي  8*4+8
ولنقارن سرعة الضرب مع سرعة الإزاحة والجمع ( اثنان ضد واحد ! من الأسرع ؟)
#include<stdio.h>
#include<windows.h>
int main()
{
    int a=GetTickCount();
        _asm{
            mov ecx,1000000000
go:
            mov eax,15
            mov ebx,5

            mul ebx//تعليمة الضرب

            loop go
        }
    int b=GetTickCount();
        _asm{
            mov ecx,1000000000
go2:
            mov eax,15
            mov ebx,5

            shl eax,2//تعليمة الإزاحة
            add eax,ebx

            loop go2
        }
    int c=GetTickCount();
    printf("mul=%i\nshl=%i\n",b-a,c-b);
    return 0;
}
تخيّل أن الجمع والإزاحة معاً .. أسرع من الضرب ! تقريبا الفرق 1435 ميللي ثانية !

هل هذا يعني أن أي عملية ضرب يمكننا تحويلها إلى إزاحة ثم جمع .. وسنصل إلى كود أسرع ؟
أترك لكم الإجابة ..

والله ولي التوفيق
2
#2
اقتباس
كثيراً ما نسمع في الأسمبلي أن عملية الضرب mul بطيئة ..

فى اختبارك اiهلت بعض الأمور:

1- الكود الذى يتم تنفيذه اولا يكون دائما الأبط و لذلك تجد فى بعض الأكواد التى تهتم بالسرعة مكتوب كود وظيفته فقط اعداد الكاش و الـ fetch و عمل كاش للتعليمات المستخدمه بكثرة.

2- تعليمة mul هى عامه لكل الأرقام و تتعامل مع حالة معينه و سيسعدنى جدا ان تريني الكود الذى يضرب الرقم 0xffffffff فى نفسه بإستخدام shift-add.

3- أغلب التعليمات التى تسخدمها ليست hard-wired و لكنها مبرمجة داخل البروسسور و عند استخدامها يتم تنفيذ Micro-op. و على حسب طبيعة التعليمه اما يقابلها واحدة او أكثر.

4- التعليمة mul تستطيع بنجاح فى ضرب رقمين بحجم 32bit و الناتج يكون يوضع بمسجلين و لإجراء هذه العملية بإستخدام shift-add لك أن تتخيل حجم المعاناه و الوقت.

5- الإسلوب shift-add يعمل مع القيم الموجبة فقط جرب تطبيقة مع القيم السالبة (للضرب استخدم imul بدلا من mul).


خلاصة القول لا توجد مقارنة بين التعليمه mul مع غيرها إلا إذا كان لديها نفس القدرات


و الله ولي التوفيق

2

مدونتي: C++ Tips and Tricks

#3

5-  بالنسبة للأعداد السالبة والموجبة سنضطر لإضافة جزء ضرب الإشارة (عمليا سيكون الضرب للقيمة المطلقة .. والإشارة حسب xor الإشارتين )

4- طبعاً لا أناقش سهولة استخدام mul وسيكون هناك طول في الكود ولا شك .. ولكن هل يمكن أن تكون أسرع في الوقت ؟

3- لا بد أن هذا هو الحال .. فتعليمات الهارد وير يفترض بها أن تتم في نبضة ساعة واحدة .. وهذا ما يدعوني للاستغراب .. لا بد أن ما قلته أنت صحيح .(هل فهمي صحيح لهذه النقطة ؟ )

2- سأعمل على الكود ( وهو ليس معقّدا إلى هذه الدرجة .. هناك( ln(n خطوة .. ولكن أيضاً لاحظت أن عملية mul لا تأخذ نفس الوقت ليجمع العمليات (مثلاً يبدو الضرب بصفر أسرع )

1- أيضاً لم أفهم هذه النقطة  ويبدو أنها هامة جداً .. هل يمكنك شرحها بقليل من الاستفاضة ..


شكرا جزيلا لك على المناقشة

#4

1- هذه النقطه تسمي بـ Instruction prefetch و يمكنك مراجعتها من wikipedia.

2- إذا كنت ستعمل على كود ففي هذه الحالة إستخدم الرقم 0x3ABCDEF0.

3- الحال هو كذلك فى معالجات CISC من Intel، و اعتقد ان الأمر مماثل مع AMD و VIA.

4- التعليمة mul سرعتها تعتمد على القيم التى تقوم بضربها ببعضها البعض مثلا قم بتجربة كود عملية ضرب الرقم من (2) فى نفسه بإستخدام mul و نفس الرقم على الكودك shift-add و راقب النتيجة.


لاحظ ان فكرة تنفيذ التعليمة مليون مرة غير عملية على الإطلاق لإنه النوع الوحيد من البرامج الذى يستخدم حلقة بهذا الحجم - الذى أعلمه - يستخدم GPU و ليس CPU لإنه حينها هذه الحلقه لن تاخذ اكثر من 5 اجزاء من الثانية.


و الله ولي التوفيق

2

مدونتي: C++ Tips and Tricks

#5

شكرا جزيلا لك ..

العملية تنفّذ مليار مرة .. والكود استغرق حوالي 11 ثانية .. وليس عندي مشكلة في ذلك ؟ أليس هذا ما قصدته ؟

أوافيك بالكود غدا بإذن الله .

#6

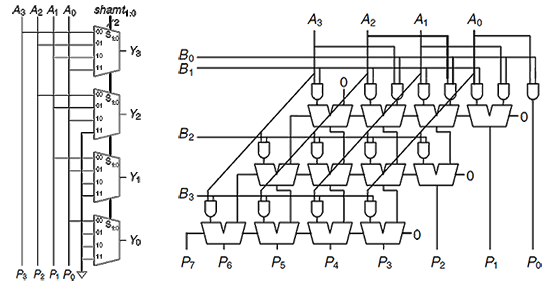
سبب بطئ عملية الضرب عائد لتعقيد الدارة المستخدمة في المعالج لعملية الضرب مقارنة بدارة الإزاحة، هذه مثلاً صورة لدائرة ضرب أربع بتات في أربع (تعطي 8 بتات) وعلى اليسار دارة الإزاحة لأربع بتات:

post-231926-0-49238200-1383823481_thumb.

عملية الإزاحة تحتاج فقط لتغيير مسار البتات باستخدام decoders، بينما في الضرب هناك عدّت صفوف من دارات الجمع و الـand تتضاعف بزيادة عدد البتات المراد ضربها، أعتقد أن الشيء الذي تفكر فيه هو نفسه الطريقة التي يضرب بها المعالج الأرقام. لو كانت هناك طريقة أفضل وأقل عتاد لاستخدمت في المعالج، ربما هناك تحسينات عليها لكنها بالتأكيد ستكون أكثر تعقيد وستزيد كلفة المعالج.


أغلب المصرفات تقوم عند تحسين البرنامج باستبدال عملية الضرب بالإزاحة إذا كان هذا ممكن في حالة أن أحد أطراف الضرب eqn.png باستخدام الطريقة eqn.png.

2
#7

ما شاء الله عليك أخي Mr.B ..

جوابك هو القول الفصل .. فالنزول إلى مستوى الكيان الصلب لا يدع مجالاً للنقاش ..

وإن كانت الدارة التي أرفقت مخططها بالفعل هي المستعملة في معالجات إنتل فهي بأربع مراحل .. وبما أنها غير متزامنة فهي لا تنتظر نبضات الساعة وهذا يبرر عدم تساوي الأزمنة بين التعليمات ..(أقصد أنني كنت أظن خطأً أن كل تعليمات الآلة تُنفّذ بزمن متساوي في RISC)

بالنسبة لعملية الإزاحة فالدارة غريبة :D لم يخطر ببالي غير Shift Register ونسيت أنه بحاجة لعدة نبضات ليتم الإزاحة :)


بالنسبة للمصرّفات فهي بالفعل تقوم بتحويل الضرب بقوى ال2 إلى إزاحة (بالنسبة لVCعلى الأقل )


وقد قمت بكتابة كود بسيط كما وعدت الأخ C++er يقوم بتحويل عملية الضرب إلى إزاحة وجمع ( ويطبع تعليمات الأسمبلي المناسبة للتحويل) ولكن لم أتأكد من أنها أسرع من mul بعد ..

هذا هو الكود ..

#include<cstdio>
int main()
{
    int a,b,c;
    scanf("%d",&a);
    scanf("%d",&b);
    printf("add eax,0\n");
    int answer=0;
    for(c=0;a;a/=2,c++)
    {
        if(a%2)
        {
            printf("mov ebx,0x%x\n",b);
            printf("shl ebx,%d\n",c);
            printf("add eax,ebx\n");
            answer+=b<<c;
        }
    }
    printf("%d\n",answer);
    return 0;
}

طبعاً يمكن تحسينه كثيراً .. ولكن الآن أريد التأكد من سرعته .. فانتظروني :p

بالتوفيق

#8

في الكود السابق .. كانت الخوارزمية المستخدمة بسيطة جداً .. وهي كما يلي ( سأشرحها بمثال)
نريد أن نضرب 12 بـ 15 و نعلم أن:

15=2^3+2^2+2^1+2^0
وعندما نضرب 12*15 فهذا يعني أننا نكتب ما يلي:
15=12*(2^3)+12*(2^2)+12*(2^1)+12*(2^0)
وكما رأينا سابقاً فإن الضرب بقوى العدد 2 يكافئ الإزاحة لليسار بنفس قيمة القوّة
15=12<<3+12<<2+12<<1+12<<0
وهذا ما نفعله كلما صادفنا 1 في ترميز الرقم .. أن نضع 12 في المسجّل ثم نزيح هذه القيمة بمقدار (رقم المنزلة)

__________________________________________________
وقد كتبت كود أفضل محسّن بشكل أكبر بكثير من السابق , لأستغني عن التعليمة mov في كل حد .. كما يلي .. وفق الخوارزمية التالية
يمكننا كتابة العدد 15 كما رأينا قبل قليل بالشكل التالي
15=2^3+2^2+2^1+2^0
الكتابة السابقة تستخدم 4 عمليات إزاحة و 3 عمليات جمع
وهو يكافئ تماماً كتابة
15=2*2*2+2*2+2+1
الكتابة السابقة تستخدم 3 عمليات ضرب و 3 جمع ..
وبإخراج العوامل المشتركة يُصبح
15=((1)*2+1)*2+1)*2+1
3عمليات ضرب و3 جمع .. وهذا هو التمثيل الأقصر على الإطلاق
وسنحوّل الضرب إلى إزاحة فيكون
15=((+1)<<1+1)<<1+1)<<1+1
ولكننا نريد الضرب بـ 12 .. والأمر بسيط  نستبدل كل +1 بــ +12
فيكون لدينا
15=((+12)<<1+12)<<1+12)<<1+12
لاحظ أن كل قوسين يمثّلان مرحلة من مراحل الحساب ..
والآن إلى كود الأسمبلي :
mov ax,0
mov bx,12
add ax,bx
shl ax,1
add ax,bx
shl ax,1
add ax,bx
shl ax,1
add ax,bx
وبتعميم المثال على جميع الحالت يمكننا كتابة الكود التالي الذي يحول عملية الضرب إلى إزاحة وجمع كما يلي:
#include<iostream>
#include<stack>
using namespace std;
int main()
{
    int a,b;
    int answer=0;
    stack <int>x;
    cin>>a>>b;
    cout<<"mov eax,0"<<endl;
    cout<<"mov ebx,"<<b<<endl;
    for(;a;a/=2)
        x.push(a%2);
    for(;!x.empty();x.pop())
    {
        cout<<"shl eax,1"<<endl;
        answer<<=1;
        if(x.top())
        {
            cout<<"add eax,ebx"<<endl;
            
            answer+=b;
        }
    }
    cout<<answer<<endl;
    return 0;
}
لا يزال هناك الكثير من الجوانب لتحسين الكود السابق , مثلاً يمكننا جمع عدة إزاحات متتالية في إزاحة واحدة
ويمكننا إزالة الإزاحة عندما يكون eax صفراً
ولكن حتى مع الكود الحالي لنتأكد من سرعة العملية كما يلي :
#include<stdio.h>
#include<windows.h>
int main()
{
    int a=GetTickCount();
        _asm{
            mov ecx,1000000000
go:
            mov eax,0xFFF
            mov ebx,0xFFF

            mul ebx//تعليمة الضرب

            loop go
        }
    int b=GetTickCount();
        _asm{
            mov ecx,1000000000
go2:
            mov eax,0xFFF
            mov ebx,0xFFF//هذه العمليات فقط للعدل مع الطريقة السابقة
            
            mov eax,0
            mov ebx,4095
            shl eax,1
            add eax,ebx
            shl eax,1
            add eax,ebx
            shl eax,1
            add eax,ebx
            shl eax,1
            add eax,ebx
            shl eax,1
            add eax,ebx
            shl eax,1
            add eax,ebx
            shl eax,1
            add eax,ebx
            shl eax,1
            add eax,ebx
            shl eax,1
            add eax,ebx
            shl eax,1
            add eax,ebx
            shl eax,1
            add eax,ebx
            shl eax,1
            add eax,ebx

            loop go2
        }
    int c=GetTickCount();
    printf("mul=%i\nshl=%i\n",b-a,c-b);
    return 0;
}
كان الفرق هذه المرة واضحاً ومحسوماً ّ! 9672 ميللي ثانية من اجل مليار عملية .. لصالح mul ! طبعاً ختارنا حالة سيئة وهي 4095 ولكن هناك ما هو أسوأ بكثير .. 65535  أو 4294967295 .. ولا داعي لإثبات فشل الاستبدال عندها .. mul تفوز :)


ولكن ماذا لو قمنا بالإزاحة والطرح بعد ذلك .. سنصل بتعليمتين للجواب :D ولكن ستبقى الحالات الوسطية هي المشكلة ..
وعلى أي حال , كانت تجربة مفيدة ..
واستقرّت الإجابة أن عملية الاستبدال فعالة في حالة الضرب بقوى العدد 2 فقط .. وفي باقي الحالات .. إما أن تكون  ذات فعالية ضئيلة جداً , أو أن تكون سيئة للغاية ..
استخدم mul وهي .. مهما كانت بطيئة .. فهي ليست ببطء الجمع والإزاحة بضعة مرات .. .. استخدمها ولا تخف .. :)

والله ولي التوفيق
#9

mul تأخذ من 3 الى 4 cycles فقط في معالجات intel . هناك تعليمات مثل div قد تصل الى 70 cycles .

في رأيي ترك التحسين للمصرف قد يكون احسن من الغوص في مثل هذه الامور , لان المعالجات تختلف و latency لكل تعليمة تختلف من معالج الي أخر .

1

مواضيع مشابهة

عدد الزوار حالياً

المتواجدون خلال آخر دقيقتين · يتحدّث كل ٣٠ ثانية

—الإجمالي—أعضاء مسجّلون—زوار بدون تسجيل

جارٍ التحقق من المتواجدين…