السلام عليكم ورحمة الله وبركاته
لنفترض أنك تريد التأكد من أن نصّ يطابق سلسة معينة تحددها, مثلاً تريد التأكد من أن النص يبدأ بالحرف a متبوع بحرف b مرة أو أكثر وينتهي بـf. في الحالة العادية ربما تستخدم التعابير المنتظمة regular expressions ويُمكنك تمثيله بـ:
^ab+f$
مثال مع بايثون :
>>> import re
>>>
>>> e = re.compile("^ab+f$")
>>>
>>> e.match("ab")
>>> e.match("abf")
<_sre.SRE_Match object at 0x018AFF60> # يعني أن النص مطابق
>>>
>>> e.match("abbbbbbbbf")
<_sre.SRE_Match object at 0x018AFA20> # يعني أن النص مطابق
>>> e.match("abbbbbbbbfq")
>>>
عملية سهله وبسيطة. لكن لو أردت عملها بدون إستخدام التعابير المنتظمة ستكون شغلة متعبة. ربما تنجح مع مثل هذا التعبير البسيط لكن إذا بدأ التعبير يكبر بقليل ستجد أن البرنامج بدأ يتعقد إلى أن تصل لباب مغلق ولاتستطيع الإستمرار. فعميلة مطابقة النصوص والتعرف عليها ليس بالشيء السهل أبداً بدون التعابير المنتظمة.
بحث عن هذا الموضوع في قوقل ووجدت إشارات لشيء يُسمى الـfinite state automata وبصراحة أنني لم أفهم أي شيء, فيبدو أن الموضوع يدرس في الجامعات لطلاب الحاسب وكل الكلام الذي وجدته نظري×نظري, رُموز رياضية ومصطلحات وأشياء لافائدة منها. لما حاولت أن أتابع هذه المحاظرة :
نمت وصحيت اليوم الثاني :haha: .
عموماً وجدت تطبيق بسيط جداً جداً وكان كل ما أحتاجه لفهم الموضوع, رجاءً إطلع عليه : Simple Finite State Machine In C
الفكرة بسيطة جداً, مثلاً في مثالنا الأول قنا أننا نريد أن نتأكّد من أنّ نصّ معين يجب أن يبدأ بـa يتبعه b فأكثر وينتهي بـf, أي سيطابق نصوص مثل:
abf
abbbf
abbbbbbbbbbbbf
لإختبارها سنقوم بالتالي:
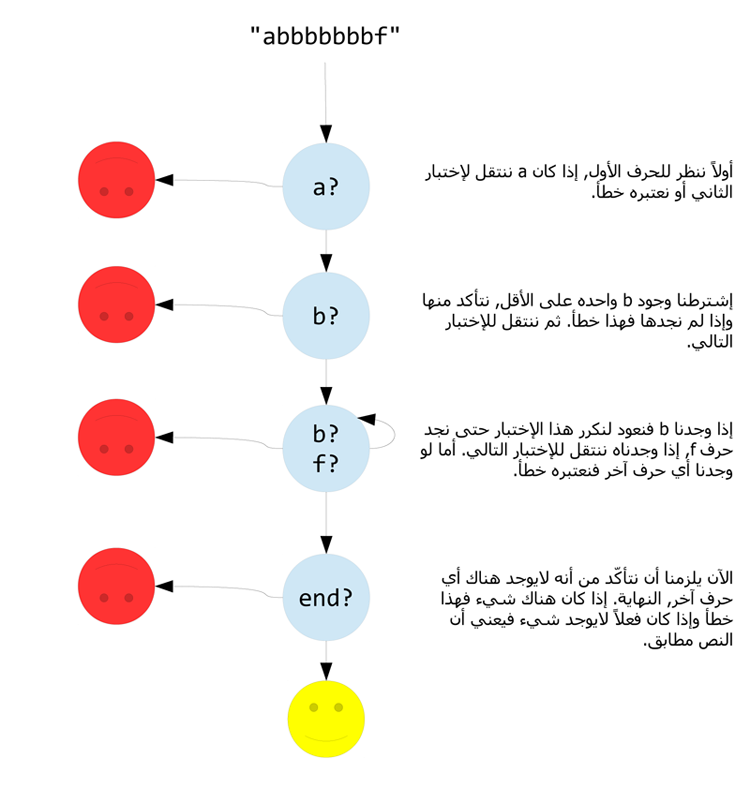
إنتبه لأشياء :
- الأسهم تمثّل قفزات لجزء آخر من البرنامج كدالة أو قفزة فعليه بإستخدام goto.
- والدوائر تُمثل الإختبار نفسه وهذا الإختبار يكون في دالة أو label إذا إستخدمت goto.
لنطبّق هذا الكلام في برنامج:
#include <stdio.h>


int main(int argc, char **argv)
{
    char *c = argv[1];

START:
    if( c == '\0' )
        goto ERROR;
    else if( *c++ == 'a' )
        goto CHECK_B;
    else
        goto ERROR;

CHECK_B:
    if( c == '\0' )
        goto ERROR;
    else if( *c++ == 'b' )
        goto CHECK_OTHER_B;
    else
        goto ERROR;

CHECK_OTHER_B:
    if( c == '\0' )
        goto ERROR;
    else if( *c == 'b' ) {
        *c++;
        goto CHECK_OTHER_B;
    }
    else if( *c == 'f' ) {
        *c++;
        goto CHECK_END;
    }
    else
        goto ERROR;

CHECK_END:
    if( *c++ == '\0' )
        goto SUCCEED;
    else
        goto ERROR;

SUCCEED:
    printf("OK! :)\n");
    return 0;

ERROR:
    printf("Error! :(\n");
    return -1;
}
إذا لم ترد إستخدام سطر الأوامر ضع النص بدل :
char *c = argv[1];
ليصبح مثلاً:
char *c = "abbbf";
لنصرفه ونجري بعض الإختبارات:
> gcc implementation.c -o lex.exe
>
> ./lex.exe abf
OK! :)
> ./lex.exe abbbf
OK! :)
> ./lex.exe abbbbbbbf
OK! :)
> ./lex.exe abbbbbbbfq
Error! :(
> ./lex.exe af
Error! :(
>
طبعاً إستخدام goto شيء محرّم في جميع اللغات لذا سنعيد بناء البرنامج ليبدو أفضل ونضيف بعض الميزات مثل التنقيح:
#include <stdio.h>
#include <ctype.h>

typedef enum _State {
    STATE_MATCH_INIT = 0,
    STATE_MATCH_FIRST_B,
    STATE_MATCH_OTHER_B,
    STATE_MATCH_LAST_F,
    STATE_SUCCEED,
    STATE_ERROR,
} State;

const char *state_string[] = {
    "STATE_MATCH_INIT",
    "STATE_MATCH_FIRST_B",
    "STATE_MATCH_OTHER_B",
    "STATE_MATCH_LAST_F",
    "STATE_SUCCEED",
    "STATE_ERROR"
};

void state_dbg(char c, State state);
int state_scan(char *str);
State state_match_init(char c);
State state_match_first_b(char c);
State state_match_other_b(char c);
State state_match_last_f(char c);

int main(int argc, char **argv)
{
    char *str = argv[1]; /* OR: char *str = "abbbbbbf"; */

    if( str == NULL ) {
        printf("Usage: %s [string]\n", argv[0]);
        return -1;
    }

    if( state_scan(str) == STATE_SUCCEED)
        printf("Done  : it matches.\n");
    else
        printf("Error : it doesn't mactch.\n");
    return 0;
}

int state_scan(char *str)
{
    char c = 0;
    State state = STATE_MATCH_INIT;

    while( (state != STATE_ERROR) && (state != STATE_SUCCEED) ) {
        c = *str++;
        state_dbg(c, state);

       switch(state) {
            case STATE_MATCH_INIT:
                state = state_match_init(c);
                break;
            case STATE_MATCH_FIRST_B:
                state = state_match_first_b(c);
                break;
            case STATE_MATCH_OTHER_B:
                state = state_match_other_b(c);
                break;
            case STATE_MATCH_LAST_F:
                state = state_match_last_f(c);
                break;
            default:
                state = STATE_ERROR;
        }
    }

    return state;
}

void state_dbg(char c, State state)
{
    c = isprint(c) ? c : '?';
    printf("Debug : %c | State = %s\n", c, state_string[state]);
}

State state_match_init(char c)
{
    if( c == 'a' )
        return STATE_MATCH_FIRST_B;
    return STATE_ERROR;
}

State state_match_first_b(char c)
{
    if( c == 'b' )
        return STATE_MATCH_OTHER_B;
    return STATE_ERROR;
}

State state_match_other_b(char c)
{
    if( c == 'b' )
        return STATE_MATCH_OTHER_B;
    else if( c == 'f' )
        return STATE_MATCH_LAST_F;
    return STATE_ERROR;
}

State state_match_last_f(char c)
{
    if( c == '\0' )
        return STATE_SUCCEED;
    return STATE_ERROR;
}
تجربته :
> ./lex.exe abf
Debug : a | State = STATE_MATCH_INIT
Debug : b | State = STATE_MATCH_FIRST_B
Debug : f | State = STATE_MATCH_OTHER_B
Debug : ? | State = STATE_MATCH_LAST_F
Done  : it matches.
> ./lex.exe abbbbf
Debug : a | State = STATE_MATCH_INIT
Debug : b | State = STATE_MATCH_FIRST_B
Debug : b | State = STATE_MATCH_OTHER_B
Debug : b | State = STATE_MATCH_OTHER_B
Debug : b | State = STATE_MATCH_OTHER_B
Debug : f | State = STATE_MATCH_OTHER_B
Debug : ? | State = STATE_MATCH_LAST_F
Done  : it matches.
> ./lex.exe abbbbfq
Debug : a | State = STATE_MATCH_INIT
Debug : b | State = STATE_MATCH_FIRST_B
Debug : b | State = STATE_MATCH_OTHER_B
Debug : b | State = STATE_MATCH_OTHER_B
Debug : b | State = STATE_MATCH_OTHER_B
Debug : f | State = STATE_MATCH_OTHER_B
Debug : q | State = STATE_MATCH_LAST_F
Error : it doesn't mactch.
> ./lex.exe af
Debug : a | State = STATE_MATCH_INIT
Debug : f | State = STATE_MATCH_FIRST_B
Error : it doesn't mactch.
>
أجمل وأنظف. حلقة التكرار while ستستمر في تمرير الحرف التالي مالم تجد خطأ أو ينتهي التحليل و switch ستعمل كموجه والإنتقال للدالة التالية. لاتعتقد أنه معقد, فقط تتبعه منذ البداية وستفهم كم هو بسيط.
مميزات هذه الطريقة :
- مهما بلغت درجة تعقيد النص فإذا أحسنت تصميم السلسلة فسيصبح تطبيقه سهل جداً, أغلب تلك الأجزاء تتكرر.
- لاتعقيد, لاحظ أنني لم أستخدم أي تخصيص للذاكرة أو دوال النصوص. ولا يوجد هناك إحتمال للخطأ, إذا كان تصميك صحيح.
- لاحاجة لإستخدام مكتبات خارجية إذا أردت مطابقة أشياء بسيطة. وأيضاً البرنامج النتاج أسرع من أي محرك تعابير المنتظمة. جرب وضع نصّ طويل وقارن سرعة التنفيذ مع أي محرك للتعابير المنظمة كـPCRE فستجده أسرع.
العيوب :
- البرنامج أطول, مقارنة بعدد من الأسطر لو إستخدمت مكتبة جاهزة للتعابير المنظمة.
- إذا صممت سلسلة وطبقتها فمن الصعب بعض الشيء أن تعدلها.
مثال لمطابقة نص أكثر تعقيد مثل عملية الإسناد في لغات البرمجة :
foo = "ABCD"; // نصّ
bar = 1234;   // رقم
- يُمكن للمعرف أن يبدأ بحرف كبير أو صغير أو _ فقط.
- يُمكن للمعرف أن يحتوي بعدها على رقم أو حرف أو _.
- يلزم وجود علامة مساواة. ويليها رقم أو نصّ بين علامتي تنصيص"".
- يجب أن تنتهي كل عملية إسناد بفاصلة منقوطة للفصل بين عمليات الإسناد.
البرنامج, كتبته الصباح ولم يأخذ الا قرابة الساعة (بدون تخطيط):
#include <stdio.h>
#include <ctype.h>

typedef enum _State {
    STATE_MATCH_INIT = 0,
    STATE_MATCH_ALPHA,
    STATE_MACH_VALUE_INIT,
    STATE_MACH_NUMBER,
    STATE_MATCH_ASSIGN,
    STATE_MATCH_STRING_INT,
    STATE_MATCH_STRING_END,
    STATE_MATCH_SEMICOLON,
    STATE_MATCH_END,
    STATE_ERROR,
    STATE_SUCCEED
} State;

const char *state_string[] = {
    "STATE_MATCH_INIT",
    "STATE_MATCH_ALPHA",
    "STATE_MACH_VALUE_INIT",
    "STATE_MACH_NUMBER",
    "STATE_MATCH_ASSIGN",
    "STATE_MATCH_STRING_INT",
    "STATE_MATCH_STRING_END",
    "STATE_MATCH_SEMICOLON",
    "STATE_MATCH_END",
    "STATE_ERROR",
    "STATE_SUCCEED"
};

void parser_debug(char c, State state);
State parser_scan(char *data);

State parser_state_match_init(char c);
State parser_state_match_alpha(char c);
State parser_state_match_assign(char c);
State parser_state_match_value_init(char c);
State parser_state_match_number(char c);
State parser_state_match_string_init(char c);
State parser_state_match_string_end(char c);
State parser_state_match_semicolon(char c);
State parser_state_match_end(char c);

int main(int argc, char **argv)
{
    char *expr = "foo = \"ABCD\";\n bar = 1234;\n\n";

    printf("%s\n", expr);
    parser_scan(expr);

    return 0;
}

void parser_debug(char c, State state)
{
    if( c == -1 ) {
        printf("Debug: START | Next: %s\n", state_string[state]);
    }
    else {
        c = isprint(c) ? c : '?';
        printf("Debug: %c     | Next: %s\n", c, state_string[state]);
    }
}

State parser_scan(char *data)
{
    char c = -1;
    State state = STATE_MATCH_INIT;

    parser_debug(c, state);

    while( (state != STATE_ERROR) && (state != STATE_SUCCEED) ) {

        c = *data++;

        switch(state) {
            case STATE_MATCH_INIT:
                state = parser_state_match_init(c);
                break;
            case STATE_MATCH_ALPHA:
                state = parser_state_match_alpha(c);
                break;
            case STATE_MACH_VALUE_INIT:
                state = parser_state_match_value_init(c);
                break;
            case STATE_MACH_NUMBER:
                state = parser_state_match_number(c);
                break;
            case STATE_MATCH_ASSIGN:
                state = parser_state_match_assign(c);
                break;
            case STATE_MATCH_STRING_INT:
                state = parser_state_match_string_init(c);
                break;
            case STATE_MATCH_STRING_END:
                state = parser_state_match_string_end(c);
                break;
            case STATE_MATCH_SEMICOLON:
                state = parser_state_match_semicolon(c);
                break;
            case STATE_MATCH_END:
                state = parser_state_match_end(c);
                break;
            default:
                return STATE_ERROR;
        }

        parser_debug(c, state);
    }

    return state;
}

State parser_state_match_init(char c)
{
    if( c == ' ' )
        return STATE_MATCH_INIT;
    if( isalpha(c) || (c == '_') )
        return STATE_MATCH_ALPHA;
    return STATE_ERROR;
}

State parser_state_match_alpha(char c)
{
    if( c == ' ' )
        return STATE_MATCH_ASSIGN;
    else if( isalnum(c) || (c == '_') )
        return STATE_MATCH_ALPHA;
    else if( c == '=' )
        return STATE_MACH_VALUE_INIT;
    return STATE_ERROR;
}

State parser_state_match_assign(char c)
{
    if( c == ' ' )
        return STATE_MATCH_ASSIGN;
    else if( c == '=' )
        return STATE_MACH_VALUE_INIT;
    return STATE_ERROR;
}

State parser_state_match_value_init(char c)
{
    if( c == ' ' )
        return STATE_MACH_VALUE_INIT;
    else if( isdigit(c) )
        return STATE_MACH_NUMBER;
    else if( c == '"' )
        return STATE_MATCH_STRING_INT;
    return STATE_ERROR;
}

State parser_state_match_number(char c)
{
    if( isdigit(c) )
        return STATE_MACH_NUMBER;
    else if( isdigit(c) )
        return STATE_MACH_NUMBER;
    else if( c == ';' )
        return STATE_SUCCEED;
    else if( c == ' ' )
        return STATE_MATCH_SEMICOLON;
    return STATE_ERROR;
}

State parser_state_match_string_init(char c)
{
    if( c == '\0' )
        return STATE_ERROR;
    return STATE_MATCH_STRING_END;
}

State parser_state_match_string_end(char c)
{
    if(c == '\0')
        return STATE_ERROR;
    else if( c == '"' )
        return STATE_MATCH_SEMICOLON;
    return STATE_MATCH_STRING_END;
}

State parser_state_match_semicolon(char c)
{
    if( c == ' ' )
        return STATE_MATCH_SEMICOLON;
    else if( c == ';' )
        return STATE_MATCH_END;
    return STATE_ERROR;
}

State parser_state_match_end(char c)
{
    if( c == '\0' )
        return STATE_SUCCEED;
    else if( (c == ' ') || ( c == '\n' ) || (c == '\r') )
        return STATE_MATCH_END;
    else if( isalpha(c) || (c == '_') )
        return STATE_MATCH_ALPHA;
    return STATE_ERROR;
}
نتيجة التحليل :
Debug: START | Next: STATE_MATCH_INIT
Debug: f     | Next: STATE_MATCH_ALPHA
Debug: o     | Next: STATE_MATCH_ALPHA
Debug: o     | Next: STATE_MATCH_ALPHA
Debug:       | Next: STATE_MATCH_ASSIGN
Debug: =     | Next: STATE_MACH_VALUE_INIT
Debug:       | Next: STATE_MACH_VALUE_INIT
Debug: "     | Next: STATE_MATCH_STRING_INT
Debug: A     | Next: STATE_MATCH_STRING_END
Debug: B     | Next: STATE_MATCH_STRING_END
Debug: C     | Next: STATE_MATCH_STRING_END
Debug: D     | Next: STATE_MATCH_STRING_END
Debug: "     | Next: STATE_MATCH_SEMICOLON
Debug: ;     | Next: STATE_MATCH_END
Debug: ?     | Next: STATE_MATCH_END
Debug:       | Next: STATE_MATCH_END
Debug: b     | Next: STATE_MATCH_ALPHA
Debug: a     | Next: STATE_MATCH_ALPHA
Debug: r     | Next: STATE_MATCH_ALPHA
Debug:       | Next: STATE_MATCH_ASSIGN
Debug: =     | Next: STATE_MACH_VALUE_INIT
Debug:       | Next: STATE_MACH_VALUE_INIT
Debug: 1     | Next: STATE_MACH_NUMBER
Debug: 2     | Next: STATE_MACH_NUMBER
Debug: 3     | Next: STATE_MACH_NUMBER
Debug: 4     | Next: STATE_MACH_NUMBER
Debug: ;     | Next: STATE_SUCCEED
الموضوع نادر ولم أجد شرح يغطي هذا الموضوع بدون التعقيدات النظرية, فنصحية أن نتحفظ بنسخة من الموضوع متى ما إحتجت إليه إرجع له.
بالتوفيق