الفريق العربي للبرمجةأرشيف المنتديات · 2000 – 2023
نسخة أرشيفية للقراءة فقط — التسجيل والمشاركة مغلقان، والمحتوى محفوظ كما كان.

منصور - محلل النصوص العربية

بدأه A_Abuzaid في 31 يناير 2012 · 15 رد · 7,694 مشاهدة · في Microsoft Visual C#.NET
مشاركة: واتساب X فيسبوك تيليجرام
#1 صاحب الموضوع

بسم الله الرحمن الرحيم

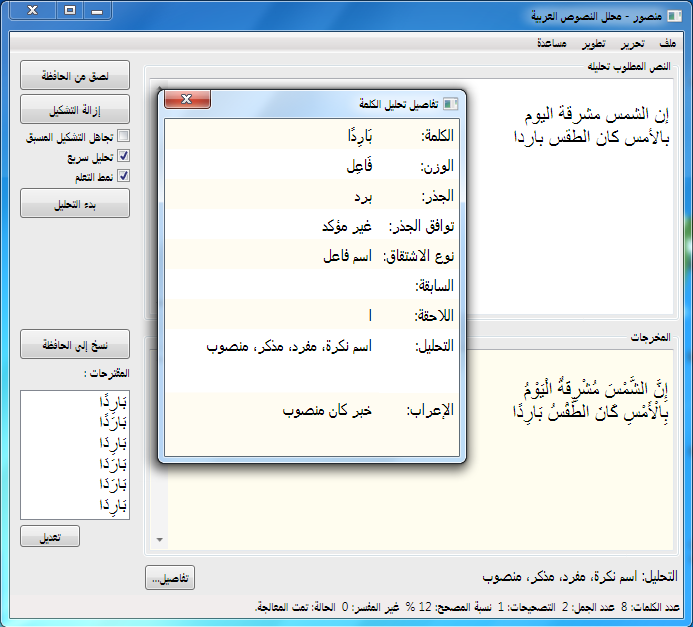
أنهيت نسخة جديدة محسنة من مشروع "منصور" محلل النصوص الرقمية العربية، الذي كنت شاركت به في مسابقة الفريق العربي للبرمجة 2011.

بعد إكمال الوظائف التي لم تكن مطبقة في واجهة البرنامج وإدخال بعض التحسينات على التطبيق يمكن اعتباره إصدارا تجريبيا للإصدار الأول.

نظرا لانشغالي الشديد خلال الشهر الماضي فلازال البرنامج ينقصه الكثير؛ قاعدة البيانات لم تكتمل بعد والتحليل النحوي يحتاج الكثير من التحسينات، لكني أعمل حاليا على ذلك.

وآمل أن يكون الإصدار الأول النهائي قريبا إن شاء الله.
post-210200-075528500 1327970701_thumb.p

الإمكانات المتاحة حاليا في المشروع:

  • التحليل الصرفي للكلمات العربية (لم يكتمل تماما).
  • التحليل النحوي للجمل القصيرة البسيطة (بالإعرابات الأساسية فقط).
  • التشكيل الآلي للنصوص بالاعتماد على نتائج التحليل الصرفي والنحوي.
  • التشكيل الآلي للكلمات الغير مفسرة (الغير عربية غالبا) بالاعتماد على تتابع الحروف.
  • إمكانية تذكر تصحيح المستخدم لاحتمالات التشكيل لكل كلمة ( حتى الآن تتعامل مع الكلمات المفردة فقط).

الإمكانات التي سأعمل على إتمامها في الإصدار النهائي (الأول):

  • إكمال قاعدة البيانات ، تحديدا ارتباطات الجذور بالأوزان الثلاثية والرباعية، وقائمة لواحق الكلمات.
  • تحسين التحليل النحوي.

يمكن تنزيل التطبيق والكود المصدري وكذلك ملف يوضح الأفكار العامة المستخدمة من موقع المشروع على SourceForge:

https://sourceforge.net/projects/mansour/

أرجو تجربة البرنامج وعرض أية مقترحات أو مشكلات أو انتقادات.

وكذلك أي مساعدة ستكون مرحب بها جدا.
المرفقات
Mansour0.1.png
21
#2

السلام عليكم ورحمه الله وبركاته

شكرا اخي على المجهود الرائع .. تمنياتي لك بالتوفيق ..

.:: Wish to become better and better ::.

#3

السلام عليكم

أردت أن أسجل إعجابي ببرنامج منصور.....فعلا مجهود تشكرا عليه

بإنتظار جديدك

#4

اكرمك الله وغمرك بالخير

#5

هلا حدثتنا أخي عبد الرحمن عن الخوارزميات المتبعة في العمل

تحياتي

تم تعديل هذه المشاركة بواسطة علاء الصالحي في 5 فبراير 2012 في 01:19

1
حزمة المحرك الإصدارة 0.8

أي أحد يجد أني ظلمته فليراسلني

وبإذن الله لو كان له حق سيأخذه

728x90.png

#6

1+

كنا نتوقع وجود السورس كود حيث انك ارفقت فقط نسخة تنفيذية من العمل

هل هناك تطبيق لل N-Gram أم فى النسخة اللاحقة

تم تعديل هذه المشاركة بواسطة طارق إبراهيم في 5 فبراير 2012 في 13:44

Technical Lead Developer

My LinkedIn Profile

اللهم قنى شر الجهل و الجهلاء

( اقْتَرَبَ لِلنَّاسِ حِسَابُهُمْ وَهُمْ فِي غَفْلَةٍ مَّعْرِضُونَ ) {الأنبياء:1}

#7
طارق إبراهيم كتب:

1+

كنا نتوقع وجود السورس كود حيث انك ارفقت فقط نسخة تنفيذية من العمل

هل هناك تطبيق لل N-Gram أم فى النسخة اللاحقة

http://sourceforge.net/projects/mansour/files/SourceCode/

#8

منصور يعتمد حاليا على التحليل الصرفي وبعض التحليل النحوي، ولا يوجد حتى الآن أي تحليل دلالي أو إحصائي حقيقي؛ لكني أدرس هذا الأمر حاليا لأنه لا يمكن بدونه تحسين دقة التشكيل (التحليل) عن مستوى معين.

الكود المصدري وتوثيق مكونات المشروع موجود بالفعل على الموقع كما علق الأخ .S.T.A.L.K.E.R جزاه الله خيرا.

https://sourceforge.net/projects/mansour/files/

بالنسبة للخوارزميات بشكل عام:

في التحليل الصرفي:

يخزن في قاعدة البيانات جدول بجذور الكلمات العربية، وجدول بالأوزان وحالات الأوزان الخاصة مع الاعتلال أو التضعيف، وتقسم الأوزان إلى قواعد اشتقاق، لأوزان الأفعال تجمع قاعدة الاشتقاق بين الفعل بأشكاله واسم الفاعل واسم المفعول والمصدر، ويكون لكل قاعدة معرف وحيد يبدأ بحرف أبجدي ويليه رقم، حيث تكون القواعد التي لها أصل واحد وحالات خاصة بالاعتلال والتضعيف لها نفس الحرف الأبجدي مع اختلاف الرقم.

يخزن لكل وزن التشكيل، والمعنى الصرفي للكلمة.

في بيانات الجذور، يفترض أن يخزن مع كل جذر قواعد الأوزان المعروف ارتباطها به، وينقسم الارتباط إلى أفعال لازمة وأفعال متعدية لمفعول وأفعال متعدية لمفعولين، وأوزان أسماء جمع وأسماء مفردة، لكن هذه البيانات لم أكمل إدخالها بعد.

ويخزن كذلك في قاعدة البيانات قائمة بالكلمات التي لها استخدام خاص، مثل الضمائر وأسماء الإشارة..، وكذلك سوابق الكلمات وملحقاتها، وجدول بأسماء الأعلام الشائعة (تعامل معاملة الأسماء المعرفة بـ الـ ).

يعتمد التحليل في الأساس على تمثيل الكلمة بسلسلة رموز نصية تعبر عن نتائج التحليل، وتشمل نوع الكلمة والعدد والجنس والحالة الإعرابية....، حيث تختلف دلالتها باختلاف نوع الكلمة : اسم N، أو فعل V، أو حرف/أداة T. وهذه الرموز تمثل الدلالة اللفظية الصرفية وليس دلالة المعنى الحقيقي (وتحتاج بعض التحسينات).

تستخدم هذه السلسلة الرمزية في اختبار توافق الوزن مع السوابق واللواحق وكذلك في التحليل الإعرابي (لأن الموقع الإعرابي قد يغير من بنية الكلمة). ولهذا يخزن لكل وزن سلسلة ترميز لمعناه، ولكل سابقة أو لاحقة سلسلة ترميز لمعناها إن كان لها معنى مستقل مثل حروف الجر، وكذلك قائمة سلاسل ترميز للكلمات التي تدخل عليها هذه السابقة أو اللاحقة (بما يشمل تأثيرها على الكلمة).

بعض السوابق أو اللواحق تمثل بمعنى مستقل بالإضافة لتأثيرها على معنى الكلمة مثل حروف الجر أو الضمائر المضافة للأسماء أو ضمائر المفعول به، وبعضها يمثل فقط بتأثيرها على الكلمة مثل ال التعريف والتاء المربوطة وضمائر الفاعل المتصلة بالفعل.

تجري المقارنة بين سلاسل ترميز المعنى هذه بما يشبه العمليات المنطقية على مستوى البت، إذا كانت إحدى الخانات بقيمة صفر يمكن أن تتوافق مع أي قيمة أخرى، وفي النهاية تكون سلسلة ترميز معنى الكلمة الإجمالية هي ناتج دمج سلاسل ترميز معنى السابقة والوزن واللاحقة.

تجلب احتمالات السوابق واللواحق من قاعدة البيانات ويختبر توافقها، ثم تجلب أوزان الكلمات المتوافقة ظاهريا مع حروف الكلمة ويختبر كذلك توافقها مع السوابق واللواحق، ثم يستعلم عن حروف الجذر التي يحددها الوزن ، فإذا لم يكن الجذر موجودا يحذف هذا الاحتمال، كذلك يختبر توافق تشكيل الوزن مع حروف الكلمة (يفيد إذا احتوت الكلمة على همزات أو حروف علة أو تضعيف)، في النهاية تولد قائمة لكل كلمة تحتوي احتمالات التحليل الصرفي لهذه الكلمة.

وإذا كان هناك احتمالين لهما نفس أصل قاعدة الاشتقاق أي أن أحدهما حالة خاصة من الآخر، يحتفظ فقط بالحالة الخاصة لأن لها أولوية. يختبر أيضا ارتباط الجذر بالوزن، فإذا كان الجذر يحتوي ضمن بياناته على رمز قاعدة اشتقاق الوزن يعتبر متوافقا وإلا يكون التوافق غير مؤكد، فإذا احتوت الاحتمالات على وزن متوافق تحذف أي احتمالات لأوزان غير مؤكدة تتشابه معه في جذع الكلمة (بدون السوابق واللواحق)، وتفرز القائمة بناء على توافق الجذور.

كذلك إذا كانت الكلمة بتشكيلها وترميز معناها مخزنة ضمن قاعدة البيانات أي سبق للمستخدم تصحيح نتيجة تحليلها، يقدم الاحتمال الذي قام المستخدم باختياره سابقا، ويخزن ضمن قاعدة البيانات لكل احتمال عدد المرات التي اختاره المستخدم فيها، وعلى أساسه ترتب التصحيحات في القائمة.

بالنسبة للتشكيل يرمز له في البرنامج بالأرقام من 0 إلى 9 والحروف من A إلى F (صادف تشابهها مع نظام العد الست عشري) والترميز يكون للحركات الصوتية وليس التشكيل (على أمل استخدامها مستقبلا في النطق الآلي). ويرمز لمكان العلامات الإعرابية بالعلامة ! للحركات المخففة و# للحركات المشددة، لتستبدل بالرمز المناسب بعد التحليل النحوي.

يدمج بين ترميز حركات التشكيل للسابقة والوزن واللاحقة لينتج سلسلة رموز التشكيل النهائية التي تطبق على الكلمة، (وهذا لأن بعض السوابق تختلف حركتها باختلاف الوزن، فتخزن حركتها مع الأوزان مثل أحرف المضارعة) وكذلك عند الدمج إذا كانت اللاحقة تؤثر على حركة الحرف السابق لها توضع هذه الحركة مكان رمز العلامة الإعرابية في تشكيل الوزن.

في التحليل النحوي:

حتى الآن لازال بسيطا (وضعيفا) جدا، إذ يعتمد على تتابع الكلمات (بالاعتماد على سلاسل ترميز معانيها)، فتخزن أنماط هذه التتابعات في قاعدة البيانات ويحدد مع كل مفردة منها رمز إعرابها (للحصول على وصفه من جدول الإعرابات).

يقوم البرنامج باليحث ضمن أنماط القواعد الإعرابية عن نمط مطابق للكلمات ولكل كلمة يبحث ضمن احتمالاتها المختلفة عن احتمال متوافق مع نمط القاعدة الإعرابية، فإذا وجده يقدمه على باقي الاحتمالات.

في بعض الحالات يكون ترميز المعنى المطلوب يمكن تكوينه بتركيب أكثر من كلمة (مثل خبر شبه جملة من جار ومجرور) فإذا لم تكن الكلمة المفردة تحقق المعنى يبحث عن نمط قاعدة إعرابية يكون ترميز معناها الإجمالي هو المعنى المطلوب فيختبر توافقها.

في النهاية يدمج ترميز المعنى التابع للإعراب مع ترميز المعنى للكلمة (بتغيير خانة الحالة الإعرابية) ويشكل بناء عليه، فإذا فشل الإعراب يشكل بناء على الإعراب الافتراضي (الرفع) إذا لم يكن ترميز المعنى يحتوي على إعراب ضمن البنية الصرفية للكلمة (مثل وزن لفعل مضارع مجزوم) أو لاتصاله بسابقة أو لاحقة (مثل حرف جر).

تجمع كل احتمالات الإعراب، وفي النهاية تطبق العلاقة الإعرابية التي تغطي أكبر عدد من الكلمات (حاليا دون أساس منطقي).

بالنسبة للكلمات التي يفشل تحليلها صرفيا:

يتعامل معها منصور على أنها أسماء أعجمية، يكون تحليلها فقط "اسم" وتشكل هذه الكلمات بناء على تتابع الحروف، بالاعتماد على ما تحتويه من حروف علة وهمزات. وهذه الخوارزمية تحتاج لتحسين ومراجعة لكنها بشكل عام تفترض أن الحركة الافتراضية هي الفتح، والحرف الثاني في مقطع الكلمة يكون ساكنا، بهذه الطريقة يمكن تشكيل نسبة لا بأس بها من الأسماء الأعجمية (تم اختبارها بشكل أساسي على أسماء الدول).

وعند وجود كلمات غير مفسرة يعرض البرنامج على المستخدم إمكانية حفظها في قاعدة البيانات وإدخال تشكيلها يدويا، بحيث تعامل ككلمة مفسرة (أعجمية) مستقبلا، ويكون ترميز معناها بناء على الخيارات التي يحددها المستخدم. يعرض البرنامج تحديد المعنى الدلالي الفعلي للكلمة؛ لكن هذه الوظيفة بلا فائدة حاليا لعدم قيام البرنامج بأي تحليل دلالي حقيقي.

توجد بعض التفاصيل الأخرى ضمن ملف توثيق المشروع.

في النهاية أود أيضا أن أنوه أن البرنامج لم يكتمل بعد، والإصدار الجديد بإذن الله سيكون متوفرا في غضون شهر أو شهرين على الأكثر بعد إكمال قاعدة البيانات وإدخال بعض التحسينات على التحليل النحوي.

فيما بعد إن شاء الله تعالى سأعمل على إضافة محلل دلالي بسيط لتحسين دقة التحليل النحوي. وبوجه عام سيعتمد البرنامج على تمكين المستخدم من تحسين جودة ودقة البرنامج بالإضافة على قاعدة البيانات المخزنة لديه (بإضافة كلمات جديدة، تحديد علاقات بين الألفاظ، أو تصحيح المقترحات).

أنا لست متخصصا في المعالجة الآلية للغات الطبيعية، ولا في اللغويات عموما أو اللغة العربية خصوصا، ولازلت مبتدئا في هذا المجال، ولهذا أحاول اكتساب المزيد من الخبرة من خلال البحث والاطلاع والممارسة، وسأكون شاكرا جدا لمن يرشدني إلى مصادر تعليمية قد تنفعني في تطوير المشروع.

2
#9

عمل أكثر من رائع ،،،، شكرا شكرا شكرا . أرجو ان تواصل هذا العمل الرائع جدا جدا يا حبذا لو تحول الى مشروع لخدمة اللغة العربية ، نسبة للضعف الشديد في هذة الناحية.

يكفيك فخرا يا أخي العزيز أن حتى شركة قووقل لم تستطع المواصلة في مشروع مماثل "Tashkeel".

#10

عمل رائع جدا ً اخي عبد العزيز , مبروك الفوز بالمركز الاولى , ربنا يوفقك ان شاء الله

M.B.O

Mohamed Bin Othman

إبن المكلا

يابني البشر ماذا فعلتم بالبشر !!

إسـألـنـي

#11

اولا أهنئك على المشروع الرائع حقيقة والفوز بالمركز الاول بالمسابقة

نصائح لتطوير البرنامج:-

1- تطوير التدقيق اللغوي والنحوي باضافة الالوان ووضع الخطوط ولا داعي لعرض مقترحات في ListBox بل عن طريق قائمة عند الضغط على الكلمة بالزر الايمن

2- استخدام قاعدة بيانات أكبر مثل السكول أو الاوركال وحميتها قدر الامكان(حتى لو انها مفتوحة المصدر)

3- تطوير GUI design & Implementation(واجهات المستخدم)

4- وضع ايقونة معتمدة للبرنامج ( حقيقة فكرته فايروس لعدم وجود ايقونة له)

5- تضمين البرنامج بالمساعدة وليس احالتها الى رابط موقع(لوجود اشخاص لا يوجد لديهم اشتراك بالنت)

6- ملاحظة اخيرة وجود تقريبا 2601 خطأ مكتشف عن طريق برنامج ida pro (والاخطاء تظهر بالاسمبلي بس تقدر تتلافاها بـ C#)

ليس خطأك أن تولد فقيرا، ولكنه خطؤك أن تموت فقيرا

#12

جزاك الله خيرا وجلعة في ميزان حسناتك

هواياتي قواعد البيانات

#13

كى تعم الفائدة ارجو من مصمم البرنامج نشر السورس وشكرا جزيلا

منو

#14

أبدعت أخي العزيز في برمجة مثل هذه البرامج...

واصل ما بدأت علية من برمجه وإلى الأمام دائماً...

كل التوفيق... :)

riiam-868466f882.gifriiam-2cf3dbc02b.gif
#15

السلام عليكم

ماشاء الله ابداع في ابداع

اسمحلي اخي A_Abuzaid ان اقول لك احسنت احسنت لا اسنت واحدة احسنت بعد الألف مليونا

__

يكفي مدحاً حتى الأن

في البداية سأبدأ بعملية تحليل البرنامج (تم التحليل المبدئي )

سأوافيك بكل اخطاء ونواقص برنامجك

في البداية لماذا لا تستخدم الأدوات التكملية للبرنامج اليك قائمة بما عليك فعلة

1- دمج القاعدة في البرنامج ليصبح ملف واحد (لأن البرنامج فية خطأ عندما لا توجد قاعدة البيانات )

2- نظرا لأن البرنامج في مجال التطوير والواضح ان القاعدة (قاعدة البيانات ) ستصبح ضخمة فلذالك استخدم ضاغطة دوت نت لتصغير الحجم

سأوافيك بالجديد حال اكمالي لتحليل البرنامج معك الى النهاية ( هذا المشروع ربما لا تعرف انة يلبي احتياجات الملاين والكثير يبحث عنة بعد انتهائك سأساعدك في نشرة

بالتوفيق :happy:

لقائنا يوم الأحد القادم ان شاء الله ;)

#16

جزاك الله خيرا

واعطاك ما تريد

وشكرا لك

مواضيع مشابهة