الفريق العربي للبرمجةأرشيف المنتديات · 2000 – 2023
نسخة أرشيفية للقراءة فقط — التسجيل والمشاركة مغلقان، والمحتوى محفوظ كما كان.

كيفية قراءة الحرف العربي في ملف html

بدأه intel3000 في 4 أكتوبر 2010 · 8 رد · 979 مشاهدة · في JavaSE
مشاركة: واتساب X فيسبوك تيليجرام
#1 صاحب الموضوع

السلام عليكم ...

لقد قمت بعمل الكود التالي ليقوم بالبحث عن الكلمة "فن" في ملف html ،وذلك بالقراءة من ملف html سطر بسطر ، حيث يقوم بالبحث عن الكلمة في كل سطر تتم قراءته ...

لكن المشكل هو ان البرنامج لا يعطي نتيجة عندما تكون الكلمة بالعربية عكس الانجليزية...

كيف يمكن حل هذا المشكل حت يصبح البرنامج يفهم العربية ...وشكرا

        try {
            URL u = new URL("c/file_test.htm");
            Scanner input = new Scanner(u.openStream());

  while (input.hasNext()) {
                if (input.nextLine().indexOf("فن") != -1) {
                    System.out.println("yas");
                } else {
                    System.out.println("no");
                }
            }

} catch (Exception ex) {
            System.out.println("erreur de URL");
        }
تم تعديل هذه المشاركة بواسطة intel3000 في 4 أكتوبر 2010 في 16:20

#2

تأكد من الـencoding الخاص بالملف وقم بإعلام الـScanner به عن طريق الـ charsetName .

public Scanner(File source,
               String charsetName)
        throws FileNotFoundException
1
#3

جرب هذه الطريقه

import java.io.BufferedReader;
import java.io.FileReader;
import java.io.IOException;
import java.util.logging.Level;
import java.util.logging.Logger;
import javax.swing.JOptionPane;

/**
 *
 * @author Mahmoud Kelany
 */
public class ReadHtmlPage {

    public static void main(String[] args) {
        try {
            FileReader reader = new FileReader("d:/test.html");
            BufferedReader bufferedReader = new BufferedReader(reader);
            int x;
            StringBuffer buffer = new StringBuffer();
            while ((x = bufferedReader.read()) != -1) {
                buffer.append((char) x);
            }
            JOptionPane.showMessageDialog(null, buffer.toString());
        } catch (IOException ex) {
            Logger.getLogger(ReadHtmlPage.class.getName()).log(Level.SEVERE, null, ex);
        }
    }
}

التعامل مع الـ IOstreams افضل من التعامل مع الـ Scanner

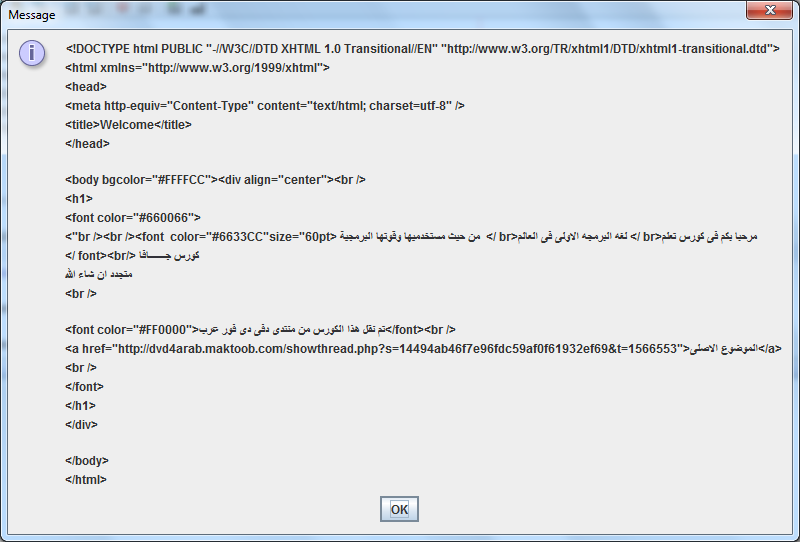
وهذه هى صوره التشغيل

post-217802-036216500 1286206314_thumb.p

وهذا هى الصفحه التى قومت بقرائتها

index.html

بالتوفيق :)

المرفقات
ArabicHtml.png

Software Developer
Mahmoudkelany.com


#4

وهذ الكود لو عاوز تستخدمها بطريقه النت

يعنى تأتى بصفحه من على النت وتعرضها

import java.io.BufferedReader;
import java.io.IOException;
import java.io.InputStreamReader;
import java.net.URL;
import java.util.logging.Level;
import java.util.logging.Logger;
import javax.swing.JOptionPane;

/**
 *
 * @author Mahmoud Kelany
 */
public class ReadHtmlPage {

    public static void main(String[] args) {
        try {
            URL url = new URL("http://www.hamzawy.eb2a.com/java/welcome.html");
            InputStreamReader reader = new InputStreamReader(url.openStream());
            BufferedReader bufferedReader = new BufferedReader(reader);
            int x;
            StringBuffer buffer = new StringBuffer();
            while ((x = bufferedReader.read()) != -1) {
                buffer.append((char) x);
            }
            JOptionPane.showMessageDialog(null, buffer.toString());
        } catch (IOException ex) {
            Logger.getLogger(ReadHtmlPage.class.getName()).log(Level.SEVERE, null, ex);
        }
    }
}

التعديل بسيط جدا فأول سطرين فقط

URL url = new URL("http://www.hamzawy.eb2a.com/java/welcome.html");
InputStreamReader reader = new InputStreamReader(url.openStream());

Software Developer
Mahmoudkelany.com


#5

Mahmoud Kelany:

FileReader يستخدم الـencoding الإفتراضي في النظام "platform default encoding"

اقتباس

The constructors of this class assume that the default character encoding and the default byte-buffer size are appropriate. To specify these values yourself, construct an InputStreamReader on a FileInputStream.

وفي المثال الذي وضعته على الأغلب ان الملف محفوظ بـ UTF-8 وبذا ظهر كل شئ دون مشاكل.

بدلاً عن إستعمال FielReader إستعمل InputStreamReader

ستحتاج لتحديد الـ encoding أيضاً.

===

على الأغلب الملفات التي يقرأها صاحب السؤال مخزونة بـ Cp1256

#6

لم ألاحظ الرد الثاني

أيضا مع استخدام InputStreamReader تحتاج لتحديد الـ encoding

على الأغلب تستطيع معرفة الـ encoding الخاص بملفات الـ html إذا وجد الـوسم الخاص بذلك ..

#7

حفظت صفحه الـ HTML

بالصيغه

ANSI

وجعلت الـ encoding فى الـ InputStreamReader

InputStreamReader reader = new InputStreamReader(new FileInputStream("d:/t.html"),"UTF-8");

لكنه لا يعمل

عملت unicode

وحددت انه يكون

InputStreamReader reader = new InputStreamReader(new FileInputStream("d:/t.html"),"unicode");

اشتغلت تمام

طيب وانا اعرف الـ encoding بتاع الملف ازاى ؟

تم تعديل هذه المشاركة بواسطة Mahmoud Kelany في 4 أكتوبر 2010 في 21:38

Software Developer
Mahmoudkelany.com


#8

اخ محمد :وضعت تعليقي قبل أن تقوم بالتعديل على ردك الأخير

عادة الصفحات يوجد فيها charset

مثلاً صفحة المنتدى charset=windows-1256"

الصفحة التي وضعت عنوانها في الكود لا أستطيع الوصول إليها وعلى الأغلب انها UTF-8

اذا لم يتم تحديد الـ charset في الملف فأعتقد المشكلة قد تصبح أكثر صعوبة

#9
YaSeenTA كتب:

اذا لم يتم تحديد الـ charset في الملف فأعتقد المشكلة قد تصبح أكثر صعوبة

هذه هى التى كنت اريد ان اعلمها

شكرا لك اخى الكريم :)

Software Developer
Mahmoudkelany.com


مواضيع مشابهة