الفريق العربي للبرمجةأرشيف المنتديات · 2000 – 2023
نسخة أرشيفية للقراءة فقط — التسجيل والمشاركة مغلقان، والمحتوى محفوظ كما كان.

نماذج خوارزميات استرجاع المعلومات Information Retrival

بدأه محمد كامل ام في 4 سبتمبر 2010 · 9 رد · 8,468 مشاهدة · في الذكاء الاصطناعي وتطبيقاته
مشاركة: واتساب X فيسبوك تيليجرام
#1 صاحب الموضوع

السلام عليكم الرجاء المساعدة عاجلة

عندي مشروع تخرج وهو مشروع بحث ولكن المطلوب القدرة على الاختيار بين نماذج خوارزميات في استرجاع المعلومات اثناء البحث وهي :

1- النموذج البولياني Boolean Model.

2- النموذج البولياني الموسع Extended Boolean Model.

3- النموذج الشعاعي Vector Model.

فأرجو شرح هذه الخورزميات وكيفية تطبيقها في c# + aspx

الرجاء المساعدة العاجلة
#2

النماذج التي ذكرتها هي طرق تستخدم لاسترجاع المعلومات ... ولكن من أين تأتي هذه المعلومات؟

الطريقة الأسهل والغير مجدية هي عمل Scan لجميع الDocuments والبحث فيها جميعها في كل مرة تريد البحث عن query ما..

الطرق الأفضل والتي تستخدمها محركات البحث، وهي تخزين هذه المعلومات في data structure معينة .. وعندما تريد البحث عن query او keywords معينة فسوف يتم البحث في تلك الdata structure وسوف تقلص زمن البحث بنسبة كبيرة جداً جداً..

كيف تبنى هذه الData structure؟

أسهل طريقة ممكنة هي عمل مصفوفة من بعدين .. الاعمدة تمثل جميع الTerms (الكلمات) التي توجد في جميع الملفات Documents ، أما الأسطر فهي تمثل الملفات Documents ID.. وسيتم وضع 1 في حال كان الملف يحتوي على الكلمة التي في العمود ، والا سيتم وضع 0 في تلك الخانة.. هذا بالنسبة للConstruction . بالنسبة للبحث في هذه الData Structure (الاسم الصحيح لها هو Document-Term Incident Matrix) فيكون من خلال boolean model وهي تطبيق العلامات المنطقية AND OR NOT في الاستعلام.. هذه الMatrix بالرغم من سهولة تطبيقها الا انها غير مجدية بتاتاً نظراً لوجود عدد ضخم جداً من الخانات سوف تكون فارغه (0) وتدعي هذه المسئلة ب Sparse Matrix.. وسوف تأكل جميع الStorage لديك بلا فائدة تذكر.. لذلك تهمل هذه الdata structure في التطبيق العملي..

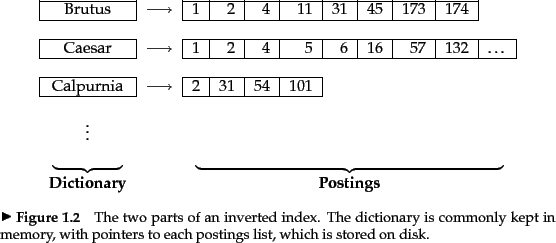
الطريقة الأفضل والتي يستخدمها جميع محركات البحث وهي بناء Inverted Index .. وهي عبارة عن عمود يحتوي على جميع الكلمات الموجودة في ملفاتك وكل من هذه الأعمدة يحتوي على مؤشر لLinked List (أو Variable Array) تحتوي على جميع الملفات التي تحتوي على هذه الكلمة.. الصورة التالية توضح ذلك:

img43.png

لاحظ أن الكلمة قيصر تكررت في الملفات 1 و 2 و 4 ... و الكلمة برتس تكررت في 1 و2 و 4 و5 والخ..

هذا بالنسبة لبناء الInverted Index .. أما لكي تبحث فيه من خلال الboolean model فمثلا لو أردنا أن نبحث عن الملفات التي تحتوي على الكلمتين قيصر و برتس ، سوف يكون شكل الاستعلام هو:

Brutus AND Caesar

والتانج هي الملفات 1 و 2 و4 ( بعد تطبيق عملية تقاطع Intersection ) بين هذه الLinked Lists.

بالنسبة لل Extended Boolean Model فهي اضافات على الطريقة الأولي والتي تفتصر على ANT NOT OR فقط وتخرج النتيجة فقط اذا كان الملف يطبق الشرط الذي قمت بكتابته في الquery.. الاضافات هي مثلا الكلمة NEAR أو LIKE والخ (تسمى proximity operator ).

أما بالنسبة للVector Space Model فهو تقريباً السائد حالياً حيث يدعم استعلام بدون تحديد جمل معينة Free Form Query اضافة الى ان الناتج يكون أفضل النتيجة best result وليس كما في الboolean/extended models فهي تخرج بدون مراعاة للSocring. لا تتوفر لدي معلومات كثيرة عن هذه الطريقة ولكن يمكنك البحث أكثر فالمصادر متوفرة ..

انصجك بهذا الكتاب لكل ما يتعلق في هذا المجال:

Introduction to Information Retrieval

بالتوفيق..

4

http://informatic-ar.com منصة تعليمية عربية في علوم الحاسب والبرمجة

https://moalfat.com  للكتب الالكترونية والكورسات التعليمية

Everything we see now is just an engineering solution based on old science

#3

السلام عليكم جميعاً

جزاك الله كل خير

لقد ساعدتني وانا جاهز لاي مساعدة لك ولاي شخص في هذا الموقع الجميل والرائع

#4

شكرا لكم على هذا الموضوع المهم جداً

سؤال هل نستطيع الحصول على كود البرمجة بلغة السي شارب, من اجل عملية انشاء بحث ضمن المستندات عن كلمة معينة حسب الخوارزميات التي تكلمت عنها

وشكرا

#5

تريد شيئاً جاهزاً يزودك بAPI تستخدمها لانشاء index والبحث فيه من خلال هذه النماذج ؟ لا يوجد أفضل من مكتبة Lucene .. ويوجد لها نسخه بالدوت نت :

http://www.codeproject.com/KB/library/IntroducingLucene.aspx

أما بناء الinverted index من الصفر فستحتاج قرائه أول 7 فصول من الكتاب في مشاركتي الأولى حتى تعرف كيف يمكن تطبيق الinverted index (الdictionary و posting list) حيث سيتم تخزين الpsoting list على القرص.. أيضا تحتاج لقرائه كيف يمكن عمل تحسين للquery حتى تسرع عملية ارجاع النتيجة.. الفصول السبعة كفيلة باعطائك خلفية جيدة عن الموضوع..

يمكن بناء الinverted index بالكامل على الذاكرة .. ربما من خلال hash table يمكن تطبيق ذلك.. ولكن هذا يعني أن جميع البيانات سوف تنتهي فور انهاء التطبيق.. الحاجة الفعلية لل RAM basesd inverted index هو السرعة في بناء الindex حيث تختلف كما هو عندما يتم الكتابة على القرص.. اذا استخدمت lucene فسوف تجد خيارات متقدمة يمكنك من خلالها بناء الindex على الذاكرة ومن ثم في وقت معين او بعد معالجة عدد معين من الملفات يمكنك كتابتها دفعه واحدة على القرص..

بعد بناء الinverted index سوف تأتي لمرحة تطبيق هذه الmodel.. الBoolean Model هو الاسهل في التطبيق والشائع منذ زمن طويل فعملية AND تتم عبر تطبيق تقاطع بين الpsoting lists للTerm المراد البحث عنها.. وعملية الOR عن طريق الانحاد.. والخ..

بالتوفيق...

1

http://informatic-ar.com منصة تعليمية عربية في علوم الحاسب والبرمجة

https://moalfat.com  للكتب الالكترونية والكورسات التعليمية

Everything we see now is just an engineering solution based on old science

#6

شكرا لك كثيرا على ردك

عموما انا كنت اسئل عن كود برمجي من اجل بناء موقع شبيه بمحرك البحث, والان قد سهلت الامور كثير بعد ردك, اذا كان هناك اي معلومات او تعليمات جديدة ارجو افادتي بها

وشكرا جزيلا

#7

lملفات قد تساعدك في الفهم ..

AI-IR.rar

IR.rar

#8

بارك الله فيكم

291964_260506123967115_206850989332629_1001538_45132_n.jpg

اللهم إني أعوذ بك من علم لا ينفع ، ومن قلب لا يخشع ، ومن نفس لا تشبع ، ومن دعوة لا يستجاب لها

#9

السلام عليكم،

اخواني انا اقوم بعمل بحث الماستر على التقارب في نموذج اللغة (language model)...ساقوم بإضافة طريقة للحصول على التقارب proximity في نموذج اللغة

المشكلة اني لا اعرف كيف احصل على شفرة النموذج source code

في الحفيقة أنا جديدة في هذا المجال و لم اكن اعرف ان الشفرة غير متاحة....توقعت ان هذه النماذج open source

هل يستطيع احدكم مساعدتي في الحصول على شفرة هذا النموذج او ارشادي الى طريقة اخرى؟؟؟

كل الشكر لاعضاء المنتدى الكرام،،،

#10

؟؟؟

مواضيع مشابهة

عدد الزوار حالياً

المتواجدون خلال آخر دقيقتين · يتحدّث كل ٣٠ ثانية

—الإجمالي—أعضاء مسجّلون—زوار بدون تسجيل

جارٍ التحقق من المتواجدين…