مفهوم الترجمة Translation
********************
لننس الآن لبعض الوقت اللغات منخفضة المستوى، ولنستكشف أكثر عالم اللغات عالية المستوى، ولنهيئ أنفسنا لبعض العمل...
في البداية، من الجيد أن نتعرف على الفكرة التي تمكننا من أن نكتب برامجنا بلغات لا يفقه المعالج منها حرفاً (بايتاً؟)، ومع ذلك يستطيع تنفيذها بكل أريحية. السبب في ذلك كما قدمت من قبل، هو أن هنالك من (يترجم) البرنامج المكتوب بلغة عالية المستوى إلى لغة الآلة. دعنا نوضح هذه العملية من منظور المبرمج:
أنت تكتب البرنامج بلغة معينة، مثلاً لغة Basic، كنص عادي مؤلف من حروف إنجليزية، ومقروء تماماً للبشر. هذا النص عبارة عن سلسلة من البايتات في الذاكرة، وكذلك هو عبارة عن نفس السلسلة من البايتات إذا تم حفظه على القرص الصلب في ملف. الذي يجعل هذه السلسلة من البايتات مقروؤة بالشكل الذي تبدو عليه هو أن الحاسوب عندما يعرضها على الشاشة أو يطبعها على الورق، فإنه يتعامل معها بصفتها رموز لنظام الترميز ASCII أو UNICODE. في النهاية، هذه البايتات لا تصلح أبداً كتعليمات يستطيع المعالج تنفيذها، وإنما تصلح فقط كرموز نصية يفهمها البشر. نحن نسمي هذا النص الكود المصدري source code. من هذه النقطة، هناك أكثر من طريق لتحويل هذا النص إلى شكل آخر يستطيع المعالج التعامل معه مباشرة. فيما يلي شرح مجمل لنوعي الترجمة الأساسيين:
- Compilation
- Interpretation
1. Compilation
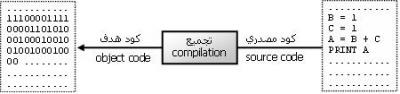
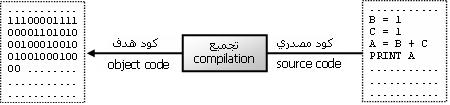
الكود المصدري يلقم كمدخلات إلى برنامج خاص، يسمى المجمّع compiler. المخرجات من هذا البرنامج هو كود من نوع آخر، لا يصلح كرموز ASCII أو UNICODE، وإنما يصلح كتعليمات للغة الآلة، وإن كان يحتاج إلى مكملات أخرى ليكون برنامجاً تنفيذياً نهائياً ينفذه المعالج. يسمى هذا الكود الناتج الكود الهدفobject code. لأن هذا الكود ليس مقروؤاً للبشر إذا فتحوه بواسطة محرر نصوص مثلاً، فإنهم يسمونه كوداً ثنائياً binary code، ليميزوه عن الكود المصدري الذي يستطيعون قراءته، على الرغم من أن كل ذلك هو في النهاية، كما سبق مراراً، هو كومة كبيرة من الصفر والواحد binary. يمكن تمثيل هذه العملية بالشكل التالي:
قلنا إن الكود الهدف ما يزال يحتاج إلى بعض المكملات، فإذا استكملها فإنه يصبح عندئذٍ قابلاً للتنفيذ بواسطة المعالج، ولذلك يسمى حينها برنامجاً تنفيذياً executable program exe. ما هي هذه المكملات التي تجعل من الكود الهدف برنامجاً تنفيذياً؟ تأتي هذه المكملات أساساً من حقيقة أن:
1. البرنامج مقسم إلى عدة أجزاء، كل جزء موجود في ملف مستقل(عدة أكواد هدف).
2. البرنامج يستخدم أكواداً في ملفات أخرى خارج الملف الذي يحوي الكود الهدف الخاص به.
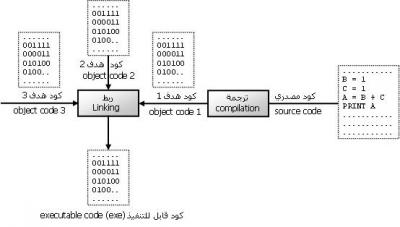
هذا يعني أن هناك حاجة في الواقع إلى (ربط) أكثر من كود هدف واحد من أجل تكوين برنامج تنفيذي نهائي. تسمى عملية الربط هذه linking، والذي يقوم بها هو برنامج يسمى linker. عندما تبرمج بلغة عالية المستوى، فإنك تجد أن هناك العديد من الأكواد (الهدف) الجاهزة التي تستطيع استخدامها في برامجك. هذه الأكواد تجمع في ملفات أكبر، وتسمى هذه الملفات مكتبات libraries. كل مبرمج يستطيع استخدام الأكواد في هذه المكتبات، لكن عملية الربط لا بد أن تتم أولاً بين برنامجه، وبين الأكواد في تلك المكتبات. أن تتعرف على هذا المفهوم هو أمر مهم جداً، لأنه سيساعدك بإذن الله لاحقاً على فهم العديد من المفاهيم، وستدرك كيف يستطيع الأكسس القيام بالكثير من المهام التي تبدو خارج نطاق تخصصه. يمكننا الآن تمثيل العملية كاملة كالتالي:
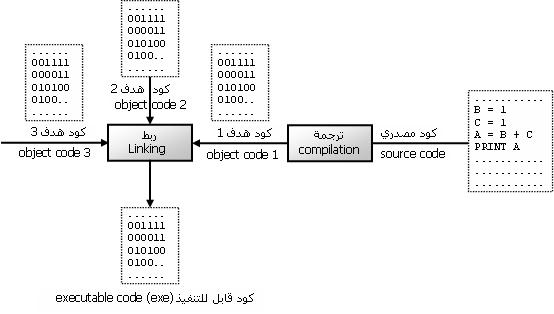
في الشكل أعلاه، كل من الأكواد الهدف object codes هو ملف مستقل، قد يمثل قسماً من أقسام برنامج واحد تم تقسيمه إلى ثلاثة ملفات، وكل ملف قد تمت ترجمته (من الشكل النصي إلى الشكل الثنائي) بواسطة المترجم على حدة. من أجل تكوين الملف التنفيذي، يتبقى ربط هذه الأقسام بعضها ببعض. أيضاً، قد تمثل بعض الملفات أكواداً جاهزة في مكتبة برمجية، تمت ترجمتها مسبقاً، ويتم ربطها مع البرنامج الذي يستخدم أكوادها.
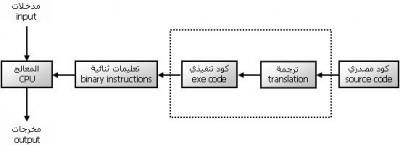
أنت تعرف الآن باقي الحكاية. الكود التنفيذي الناتج يلقم مع أية إدخالات إلى المعالج، ويقوم هذا الأخير بتنفيذه وإنتاج المخرجات. إذا اتفقنا على أن نسمي المراحل ابتداءً من استلام الكود المصدري وانتهاءً بالكود التنفيذي بـ (ترجمة translation)، فالشكل التالي يجمل العملية حتى الحصول على مخرجات البرنامج:
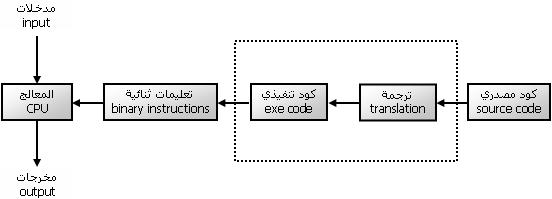
في الأساس، عملية تنفيذ البرنامج قد تمت على مرحلتين: المرحلة الأولى لترجمة الكود المصدري كاملاً إلى كود تنفيذي، والمرحلة الثانية للتنفيذ الفعلي لهذا الكود التنفيذي بواسطة المعالج.
2. Interpretation
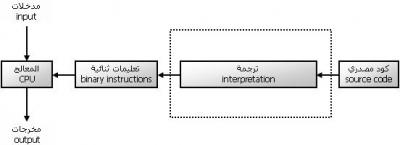
هناك نوع آخر من الترجمة، يسمى interpretation، حيث يتم تنفيذ الكود المصدري مباشرة بواسطة برنامج يسمى interpreter، دون المرور على مرحلة إنتاج كود تنفيذي. الشكل في الأعلى لمجمل عملية التنفيذ يصبح كالتالي:
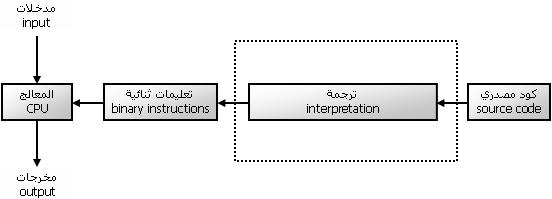
في الأصل، كانت الفكرة الأولى لعمل هذا النوع من المترجمات هي أن يقرأ المترجم الكود المصدري سطراً بسطر، ويحول كل سطر آنيّاً إلى تعليمات ينفذها المعالج مباشرة. ليس هناك ناتج إضافي عن هذه العملية، مثل الكود الهدف في حالة الـ compiler. في الأساس، يعمل المترجم هنا كأنه معالج افتراضي، يفهم لغة الكود المصدري، وينفذها مباشرة. في الحقيقة، المعالج الحقيقي هو الذي ينفذ الكود بعد تحويله (على الطاير) إلى لغته الخاصة. لاحظ أنك بحاجة إلى وجود المترجم دائماً عند تنفيذ الكود المصدري.
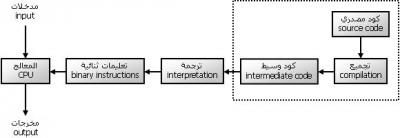
الآن، تغيرت الفكرة بعض الشيء، وتداخلت الأمور، وأصبحت الترجمة تحوي مزيجاً من النوعين السابقين. أصبح الـ interpreter في الغالب يستخدم خطوة تمهيدية تشبه تماماً عمل الـ compiler، لكنها لا تنتج كوداً هدفاً object code، وإنما تنتج كوداً وسيطاً intermediate code، يستخدم هو فيما بعد في عملية الترجمة (على الطاير). يمكن أن أقرّب هذا المفهوم بالشكل التالي:
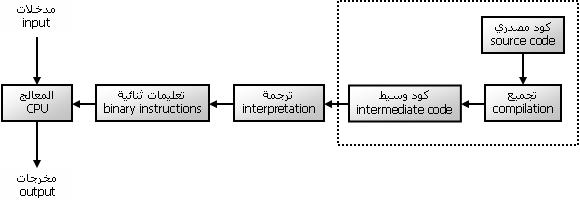
المربع المخطط في الشكل أعلاه يمثل مرحلة مستقلة، قد تتم في أي وقت قبل وقت التنفيذ الفعلي للبرنامج؛ بمعنى أنه يمكن أن يتم تحويل الكود المصدري إلى كود وسيط، والاحتفاظ بهذا الكود الوسيط على القرص الصلب مثلاً حتى وقت لاحق. يشبه ذلك تكوين الملف التنفيذي في حالة التجميع compilation. الفرق الواضح هنا هو أن الكود الوسيط ما يزال يحتاج إلى الـinterpreter من أجل الترجمة الفورية، والتنفيذ الفعلي للبرنامج. مثال على هذه الطريقة الترجمة في لغة Java، حيث تتم الترجمة على مرحلتين: مرحلة تنتج الكود الوسيط الذي يسمى byte code، وهي مرحلة تجميع compilation، ثم مرحلة التنفيذ التي يقوم بها الـinterpreter، بتحويل الـbyte code إلى لغة المعالج مباشرة. يسمى هذا الـinterpreter في حالة الجافا بـ(الآلة الافتراضية للجافا Java Virtual Machine JVM)، ولذلك تحتاج إلى تثبيت هذا البرنامج في جهازك قبل أن تستخدم برامج جافا.
الأمر شبيه بذلك في حالة لغة Visual Basic for Applications VBA. الجديد هنا هو أن الكود المصدري مع الكود الوسيط يتم حفظهما معاً ضمن ملف قاعدة بيانات الأكسس ذي اللاحقة mdb (أو accdb). بعد أن تكتب الكود المصدري بلغة VBA، يتم تجميعه compiled إلى كود وسيط يسمى p-code. عندما يعمل تطبيق قاعدة البيانات، ويستخدم أكواد VBA، تتم ترجمة هذا الكود الوسيط وتنفيذ الكود بواسطة الأكسس، ولذلك تحتاج إلى وجود الأكسس دوماً (أو على الأقل إلى وجود المكونات التي تقوم بالترجمة).
السؤال الذي يطرح نفسه هنا هو التالي: مع ملاحظة أن الكود المصدري بلغة VBA قد تمت ترجمته إلى الكود الوسيط p-code ، ألا يعني هذا أن بإمكاننا الآن أن نتخلص من الكود المصدري، ونحتفظ بالكود الوسيط، ولن نخسر شيئاً؟ الجواب: بلى، بإمكاننا أن نتخلص من الكود المصدري، لكن هذا يعني أننا لن نستطيع القيام بأي تعديلات في الكود لاحقاً. في الحقيقة، الأكسس يوفر لنا هذه الخاصية من أجل حماية الكود المصدري من التعديل، وتقليص حجم ملف قاعدة البيانات. يتم ذلك عبر تحويل كل الأكواد المصدرية في الملف إلى كود وسيط p-code، ثم التخلص من الكود المصدري، وضغط الملف بعدها وتحويل الامتداد إلى mde (أو accde) بدلاً من mdb. ومن هنا تعرف السر في أنك لا تستطيع الاطلاع على أكواد ملفات mde، مع أن التطبيق يعمل بشكل كامل.
في آخر هذه الحلقة، تأكد من أنك تدرك الآن معنى المصطلحات التالية (بشكل مبدئي):
Compiler
Interpreter
Source code
Object code
Executable code
Linker
Library
Intermediate code
JVM
P-code
والمفاهيم التالية:
الحاجة إلى الترجمة
أنواع الترجمة
فكرة المكتبات البرمجية
الحاجة إلى JVM من أجل تشغيل تطبيقات جافا
طبيعة ملفات mde
(يتبع إن شاء الله...)