الفريق العربي للبرمجةأرشيف المنتديات · 2000 – 2023
نسخة أرشيفية للقراءة فقط — التسجيل والمشاركة مغلقان، والمحتوى محفوظ كما كان.

فكرة لضغط الملفات ...!

بدأه HaTy في 8 مارس 2009 · 17 رد · 1,620 مشاهدة · في لغة C و ++C
مشاركة: واتساب X فيسبوك تيليجرام
#1 صاحب الموضوع

بســم الله الـرحمــن الرحيــم

السلام عليكــم ورحمـة الله وبركاتــة ،،

قرأت في مواضيع متفرقة على صفحات هذا المنتدى بعض الاقترحات لضغط الملفات وكان من ضمنها هذا الموضوع

وكان فيه اقتراح لعمل ورشة لهذا لتصميم خوارزمية ضغط ولكن يبدو انه لم يتم عملها

المهم لدي فكرة لضغط البيانات الثنائية اي بشكلها الـ Hex وهو نمط البيانات المفضل

لدي بالاضافة للمصفوفات طبعا :lol:

حسنا لن اشرح الفكرة الان ولكن لنرى ان كنتم ستتوصلون لها من هذه الـ Tips في الشكل الاتي

- معروف ان اصغر وحدة يمكننا استخلاصها مباشرة هي البايت BYTE او unsigned char

- ومعروف ايضا ان البايت BYTE به ثمانية 8 بت Bit

- ايظا معروف ان البت Bit يحمل قيمتين اما 0 او 1

- وعليه فإن عدد الاحتمالات التي يمكن ان يحملها 1 بايت BYTE مساوية لـ 2*8^2 اي 256 احتمال

وهي من 0 الى 255 وتمثل بالهيكس من 0x00 الى 0xFF المناضرة لـ 00000000 الى 11111111

بالنضام الثنائي Binary .

حسنا لنفرض الان ان لدينا بايت واحد نريد ضغطه ولتكن قيمته 0x2A وهو بالطبع سياخذ 8 بت اي القيمة

00101010

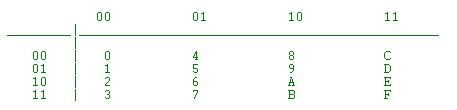
السؤال هنا هل يمكنكم تمثيل البايت السابق في 6 بت فقط اعتمادا على الشكل الاتي
post-129961-1236513311_thumb.jpg

اذا استطعتم ذلك وانا واثق من ذلك ان شاء الله ,فسيتم توفير عدد 2 بت وبالتالى تقليل حجم الملف , بانتظار افكاركم

ملاحظة : يمكن عمل ذلك وان لم تتمكنوا من التوصل لطريقة الحل ساشرحها لكم ان شاء الله

تحياتي

تم تعديل هذه المشاركة بواسطة haty في 8 مارس 2009 في 15:20

while( "اسلام" )
{
 cout >> "الموت لبني صهيون" >> endl;
}
return "فلسطين";
#2

الفكرة رائعة ... لكن انت ستوفر 2 byte فقط ، يعنى 1/4 من المساحة المستخدمة ... هل هذه النسبة مجدية ام هناك بدائل توفر مساحة اكثر ؟

اعتقد انه يمكن تطوير فكرتك لتوفير 3 أو 4 bytes يعنى 50% من المساحة المستخدمة ... اعتقد أحسن :D :D

#3

الموضوع لن يصلح والسبب بسيط .. أن عليك أن توحد معيار التخزين في القرص .. إن كنت تتحدث عن الثنائية يجب أن يكون الإختزال يعطي نتيجة عدد ثنائي ليتم تخزينه في القرص على شكل عدد ثنائي , وإن كنت تتعامل على مستوى الأعداد العشرية يجب أن يصبح الإختزال لعشري ليتم تخزينه كعشري وكذلك لل Hex وأي نوع ترقيم جديد تقوم بتحديده أو إختراعه .

يعني مثلا في طريقتك لو كانت القيمة 1111 فإن المقابل حسب الجدول هو F , فلا يمكن أن تفترض أن القيمة في الملف كانت مخزنة 1111 ثم تريد أن تخزنها كبايت واحد F ... السؤال هنا كيف ستخزن F في الملف ؟ إن إفترضت أن توحيد التخزين ثنائي يجب أن تجد طريقة لتمثل F في الملف وقيمة F الثنائية هي بالضبط 1111 ! يعني أعدت الأمر لما هو عليه تماما !

شيء آخر إنتبه لموضوع حساس جدا في خوارزميات الضغط , لاتوجد خوارزمية ضغط تضغط أي شيء حتى الآن , وإن إكتشفت خوارزمية ضغط تضغط كل شيء مهما كان فإنك بهذه الطريقة قمت بإيجاد مايسمى ال perfect compression "طبعا بدون فقدان بيانات كما يحدث في ضغط الفيدو والصور" أي أن الخوارزمية lossless فستستطيع بيع الخوارزمية بمبلغ من 7 أصفار وأكثر ;)

والسبب أنه لو أوجدت خوارزمية تضغط كل شيء فإن البيانات بعد الضغط لاتزال بيانات ويمكن ضغطها من جديد بنفس الخوارزمية لأنها تضغط كل شيء , وبالتالي تضغط ماضغط وتضغط حتى تحول الملف لبايت واحد , أو أقل وحدة يمكن التخزين على أساساها .

لذلك إن وجدت خوارزمية تضغط كل شيء فتأكد أن هناك خطأ ما .

banner_60_468.gif

NOTHING IS IMPOSSIBLE

#4
اقتباس
الفكرة رائعة ... لكن انت ستوفر 2 byte فقط ، يعنى 1/4 من المساحة المستخدمة ... هل هذه النسبة مجدية ام هناك بدائل توفر مساحة اكثر ؟

اعتقد انه يمكن تطوير فكرتك لتوفير 3 أو 4 bytes يعنى 50% من المساحة المستخدمة ... اعتقد أحسن

+1

بمناسبة الاقتراحات

ما رايكم بحل المعادلات الرياضية عن طريق التخمين(بنفس الطريقة القديمة لكشف الباسورد ) (للاستفادة من سرعة المعالجة )

تم تعديل هذه المشاركة بواسطة apex في 8 مارس 2009 في 20:06

name : mohamedyosry

#5

haty يبدو أن لديك شيء آخر غائب عني فياريت لو شرحت الطريقة لنعرف الوضع ..

اقتباس
ما رايكم بحل المعادلات الرياضية عن طريق التخمين(بنفس الطريقة القديمة لكشف الباسورد ) (للاستفادة من سرعة المعالجة )

يمكن حل أغلب المعادلات بطريقة التنصيف لتقريب النتيجة وهي كما تقول ك brute force لكن بتناقص لوغارتيمي للأساس 2

banner_60_468.gif

NOTHING IS IMPOSSIBLE

#6

أنا مع هيثم، لا أدري كيف تريد الجمع بين نظامين للتمثيل

Do as I say, not as I do

We are Anonymous. We are Legion. We don't forgive. We don't forget

#7

السلام عليكم

والله حبيت اضيف معلومات بسيطه عسى ان تكون نافعه بخصوص التشفير ومن يريد ان يتزود يبحث عنها في محركات البحث .

اولا هناك نوعان من التشفير :

1- a lossless compression method

هي عملية ضغط البيانات الاصلية مع الحفاظ عليها عند فك الضغط .

مثال :

Run-length encoding

Variable-length lossless codes

GIF (graphical interchange format) coding

2- a lossy compression method

اما اللوسي , فهي عملية تقوم بضغط البيانات الاصلية مع عدم المراعاة عند فك الضغط للبيانات الاصلية .

مثال :

JPEG (Joint Pictures Experts Group) - للصور

MPEG (Motion Pictures Experts Group) للفيدو

MP3 (MPEG Audio Layer 3) للصوت

اختر انت الان اي نوع يعجبك :) وابدا فيه مشروعك .

تم تعديل هذه المشاركة بواسطة azeez00 في 10 مارس 2009 في 02:53

سبحان الله , الله اكبر , ولله الحمد

#8

بســم الله الـرحمــن الرحيــم

السلام عليكــم ورحمـة الله وبركاتــة ،،

اولا - للاخوة الذين يتسألون عن دمج نوعين من البيانات , الحقيقة لن يتم التعامل مع نوعين مختلفين من البيانات

بل سيتم قرأة الملف في صورته الثنائية ثم محاولة ضغط البايتات تباعا وتمثيلها بشكل ثنائي ثم كتابتها في صورتها

الثنائية من جديد وعند فك الضغط سيتم عكس الخطوات التي تم عملها في الضغط

لنعطي مثال هنا حتى يتم توضيح الصورة فمثلا لو اردنا ضغط البايت حسب المثال في المشاركة الاولى وهو 0x2A

وحسب الجدول الثنائي نعلم انه سيكون بالقيمة 00101010 اي 2 مقابلة لي 0010 و A مقابلة لـ 1010

وكل من الرمزين 2 و A سيكون ممثلا بعنوانين احدهما افقي والاخر عمودي , فلنرى امكانية الضغط العمودي

حسنا , في هذه الحالة يمكن تمثيل 2 كـ 10 اي اهمال عنوانها العمودي لانه صفرين ومن الجدول الاتي نرى انه يمكن

ضغط الرموز 0 و 1 و 2 و 3 لإن عناوينها العمودية كلها 00 وبقراءة البايت من اليسار لليمين نستطيع ضغط البايت

السابق بحيث يصبح في هذا الشكل 101010xx والبتين 2Bits الاخرين الممثلين بالرموز xx نستخدمها في تعبئة بيانات

جديدة من البايت القادم في الضغط لانه يستحيل كتابة البايت بعدد اقل من 8 بت , وبالطبع بعد ضغط الملف بهذه الاسلوب

نستطيع تطبيق نفس الفكرة في الضغط الافقي لزيادة ضغط الملف ارجو ان تكون الفكرة وضحت

post-129961-1236651908_thumb.jpg

الاخ عزيز معلوماتك دقيقة وبالنسبة للضغط Lossless فاعتقد افضل خوارزمية عن تجربتي الشخصية هي gzip

لـ Mark adler وهي مجانية و مفتوحة المصدر و تقدم عدة خيارات اهمها ارجاع الملف كـ Byte Identical

وهو ملا تقدمه الخوارزميات المشابهة

تحياتي

تم تعديل هذه المشاركة بواسطة haty في 10 مارس 2009 في 05:28

while( "اسلام" )
{
 cout >> "الموت لبني صهيون" >> endl;
}
return "فلسطين";
#9

0x2A = 0010 1010b // empty space left for quick recognition

according to your method, 0x20 will be represented by only 10b, discarding the first 00b correct?

while 0x0A will remain the same as 1010b. having 2 bits to use in hand, OK?

now let's assume we have this simple series of hexadecimal values, 0x2AFFF204

0x2A = xx101010b << you can't really fill in the first number gap, because nothing precedes it.

0xFF = 11111111b << nothing to compress, so you don't get a gap in every byte.

0xF2 = 1111xx10b << a gap in the center between other bits.. things getting harder

0x04 = xxxx01xxb << three gaps.

now let's put this in a series of bits

xx101010111111111111xx10xxxx01xx

you say you are gonna fill this gap by bits of the following number, how are you planning on doing this?

how are you going to mark the gaps that have been filled

how are you going to differentiate between bytes of different bits combination.

in other words, give me an algorithm that works.

تم تعديل هذه المشاركة بواسطة Xacker في 10 مارس 2009 في 18:28

Do as I say, not as I do

We are Anonymous. We are Legion. We don't forgive. We don't forget

#10

تشكر اخي على الموضوع

وصراحة كنت اريد المشاركه بالموضوع لكن للأسف .

منذ طرحي للموضوع السابق وانا ابحث وتوصلت لأفكار لا بأس بها

مع العلم اني كنت اتوقع الموضوع اسهل من كذا لكن يبدوا انه متشعب

وتواجه مفترق طرق كلما تقدمت .

قد يزعل مني البعض لكن هذا واقع (وقد يسخر البعض الاخر)

إذا تم التوصل لخوارزميه مبهره فإنني للأسف لن اطرحها لكن

إذا توقفت عند مجال معين سوف اطرح ما توصلت إليه لكي يستفيد الاخرون( رب ضارة نافعة ) .

فللأسف نفتقر للبحث العلمي الجماعي ( بالنهايه هذا رأيي ) .

للمعلومية تم الوصول لنتائج 20% من الضغط كحد ادنى لأي بيانات و بإنتظار القادم .

متغيب

#11

السلام عليكم ,,

الحقيقة اعذرني و لكني لم أفهم الطريقة :) هل من الممكن أن تشرح أكثر...

ما أفهمه أنك تقول أن هذه الخوارزمية Lossless, جيد إذا لا نهتم لطبيعة البيانات نفسها و إنما مجرد عملية إحصاء بسيطة,

أنت لا تقوم بعملية ضغط كل ما تقوم به هو تحويل الصيغة الثنائية إلى الصيغة الستعشرية,

حسب ما تقول الخوارزمية فإن عدد العناصر لديك هو 16 عنصر و المطلوب أربع أرقام ثنائية لتمثيل هذه القيمة, هل ترى ؟

إذا أخذنا بمثالك فلن يمكننا ضغط العدد 0xFF, لأنه سيبقى من أربع خانات و هي عنوانه الأفقي و العامودي,

هنا ظهرت مشكلة جديدة, كيف سنعيد البيانات المضغوطة إلى حالتها الأصلية ؟ فنحن لا نعرف أصلاً حجم وحدة البيانات المضغوطة ؟ّ!

هل الذي تريد عمله هو كهذه الخورازمية ؟

Huffman coding

هذه تمثل البيانات في سلاسل بدلاً خانات ثابتة,

هل يمكن أن تعطينا مثال يوضح أكثر كيفية ضغط سلسة مكونة من 8 bytes خطوة بخطوة, كيف ستقوم بالضغط و من ثم إعادة البيانات المضغوطة إلى شكلها الأصلي...

تحياتي ,,

#12

LEFT TO RIGHT

Hi - Xacker,

What you said is right in some aspects.

though, there is a method to represent the Byte's data in less Bits, we could not use it at all cases .also we should find a way to refer to the compressed Bytes to distinguish them for later decompression processes .

Well, let's have an example to clear things up.

if we have these two Bytes 0x2AFF ,then according to the binary table, the data should looks as this:

2A = 00101010 , FF = 11111111

Original data = 0010101011111111

Compressed Data = 10101011111111xx

it is clear we have saved 2 bits and they could be occupied by the data of the next Byte .

on Decompression ,it's difficult to tell which byte is compressed and which is not .

and here is the dilemma ,and here is the Trick مربط الفرس

Obviously, it is simple to decompress the data if we could somehow refer the compressed data ummmmmmmmm!!!

Well to explain my approach to solve this problem, I have to draw your attention to the following points:

we should consider that, the longer the data, the more compressible it become.

We are dealing with Binary-Files, and that gives us the ability to do whatever we like.

So, lets have some Out-File Bytes for Indexing purposes, which by we can represent the byte state as compressed or not ,and as we deal with Binary, let us consider 0 as Uncompressed, 1 as Compressed .

Well, ...back to the previous example 0x2AFF = 101010-11111111xx

and by using Indexing-Bytes the first one of the Indexing Bytes should be 10xxxxxx which mean the first byte is compressed and the second is uncompressed.

and by applying this technique for Indexing We will need 1 Byte for indexing 8 Bytes

128 Bytes to index 1 Kbytes

128 Kbytes to index 1 Mbytes

128 Mbytes to index 1 Gbytes

Therefore a more advanced compression table should be used. And what I suggest is an arrays table i.e.

a Main Table that has Sub-Tables as elements.

The first element in the main table would be a table begins from 0x00 to 0x0F.

The second element in the main table would be a table begins from 0x10 to 0x1F and so on.

post-129961-1236757121_thumb.jpg

LEFT TO RIGHT

And by using the same technique for Indexing The first four Bits in the Indexing Byte give us the ability to have 16 possibilities representing the Sub-Table position within the Main Table.

the next 4 Bits represent the Byte Location within the Sub-Table

Of course we can compress the resulting Indexing-Bytes ,then attach them to the compressed file as a key for decompressing.

also we can make another compression in the horizontal order .

finally it seems as a Crazy Idea but I think it's a Clever one.

So if any one implements this idea plz refer to it as Ali's Algorithm.

تم تعديل هذه المشاركة بواسطة haty في 11 مارس 2009 في 11:02

while( "اسلام" )
{
 cout >> "الموت لبني صهيون" >> endl;
}
return "فلسطين";
#13

بســم الله الـرحمــن الرحيــم

السلام عليكــم ورحمـة الله وبركاتــة ،،

شكرا لكل من قام بالرد على الموضوع

اعتقد ان الفكرة واضحة بامكانية ضغط الملفات تبقى المشكلة في تمييز البايتات التي تم ضغها

والامر كما اوضحت في ردي على الاخ Xracker وذلك باستخدام بايتات للفهرسة وعليه

كل بايت سيعطي امكانية فهرسة ثمانية بايتات ولكن هذا من جهة اخرى سيزيد حجم الملف

هنا يجب التنويه انه كلما كبر حجم الملف كلما زادت امكانية الضغط

ايظا يمكننا ضغط هذه البايتات الاضافية المستخدمة في الفهرسة لتقليل الحجم

ثم استخدام جدول به جداول فرعية لتمثيل البايتات مما يعطي امكانية ضغط اكبر

ارجو ان تكون الفكرة وضحت لكم واي استفسار انا جاهز

تحياتي

while( "اسلام" )
{
 cout >> "الموت لبني صهيون" >> endl;
}
return "فلسطين";
#14

يا أخي علي فيما ذكرته في الأعلى أنت تتكلم عن تحديد الـ "بايتات" التي تم ضغطها، وقبل أن أعود لفكرتي سأناقشك في فكرتك.

لنفرض لديك ملف حجمه 100 بايت، منها 20 بايت فقط يمكن ضغطه والباقي لا، في الـ 20 بايت تستطيع توفير 2 بت في كل بايت يعني لديك توفير 40 بت أي بمقدار 5 بايت من حجم الملف الكلي.

الآن سيلزمك من أجل كل 8 بايتات > 1 indexing-byte كما أسميتها، أي بقسمة بسيطة سيلزمك من أجل كل 100 بايت > 12 indexing-bytes و نصف أي nibble.

وبهذا أنت أنقصت حجم الملف إلى 95 بايت ثم أعدت رفعه إلى 107 بايت ونصف. انتهى الضغط تماماً بمثال رميت أرقامه بشكل عشوائي.

هذه فكرتك ناقشتك فيها.

---------

الآن نأتي إلى ما كنت أتكلم عنه في الأعلى، "كيف ستحدد البتات التي تم ضغطها وليس البايتات" ؟

indexing-bits ؟

أصبح لديك الآن من أجل كل 2 بت ستحتاج إلى indexing bit واحد أي من أجل بايت سيلزمك nibble ومن أجل 100 بايت كما في المثال السابق سيلزمك 50 بايت تحدد فيها فقط ما تم ضغطه.

هذه الطريقة أقرب إلى أن تكون للتشفير "التعمية كما تسميها بعض المراجع - cryptography"، منها إلى أن تكون للضغط.

Do as I say, not as I do

We are Anonymous. We are Legion. We don't forgive. We don't forget

#15

بســم الله الـرحمــن الرحيــم

السلام عليكــم ورحمـة الله وبركاتــة ،،

اهلا اخي Xacker

حقيقةَ ما اوصلني لهذا الفكرة في البداية هو محاولتي لتشفير البيانات

وكما قلت سابقا كلما زاد حجم الملف زادت قابليته للضغط وكما هو معروف فإن ضغط البيانات الصغيرة سيزيد من حجمها ويمكن تجربة ذلك باي من خوارزميات الضغط المستخدمة في برامج الارشفة مثل winrar و البرامج الشبيهة , وايظا في مرحلة ما من معاودة الضغط المتكرر تصبح عملية الضغط مسببة في زيادة الحجم بدل انقاصه Crictal Size .

حسنا ما تطرقتُ اليه في ردي السابق من استخدام جدول به جداول فرعية سيوفر فرصة اكبر بكثير من استخدام الجدول الثنائي فبدل العنونة لانصاف البايتات ان صح التعبير ستتم العنونة لبايتات كاملة

ايظا الضغط في الشرح السابق كان في الاتجاه العمودي فقط ولذلك نستطيع الضغط في الاتجاه الافقي ايظا بنفس الفكرة بعد اتمام الضغط العمودي مما يعطي احتمالية لمضاعفة نسبة الضغط .

امر اخر قابلية البيانات للضغط مسئلة نسبية فمثلا في مثالنا كان شرط الضغط ان يكون العنوان العمودي " البتين الاولين من اليسار" مساويا لـ 00 وهنا تتضح استحالة ضغط البايات FF وهو مساوي لـ 11111111 ولكن ماذا لو كان شرط الضغط ان يكون العنوان العمودي 11 وليس 00 فهنا سينعكس الوضع تماما

فلو طبقنا الضغط بمعيار 00 اولا في الاتجاهين الافقي و الرائسي ثم اعدنا الضغط من جديد بمعيار 11 الن تتوفر فرصة كبيرة لانقاص حجم الملف ؟

ما اراه في هذه المقترح فكرة قابلة للتطبيق وقد لا يراها البعض كذلك , لكن لو امعنتم النظر في الفكرة لوجدتموها منطقية تماما

تحياتي

تم تعديل هذه المشاركة بواسطة haty في 11 مارس 2009 في 16:30

while( "اسلام" )
{
 cout >> "الموت لبني صهيون" >> endl;
}
return "فلسطين";
#16

برامج الأرشفة مثل Winrar تقوم بتشكيل صيغة ملف جديدة تماماً، أرشيف، يحوي بداخله على metadata للملف وعلى الـ data نفسها، وعلى بعض خيارات التحقق من الدقة وعلى خوارزميات ومعلومات أخرى، أكيد عندما تريد ضغط ملف صغير الحجم سيزيد حجمه إن كانت نسبة الضغط قليلة لأنه سيقوم بتشكيل ملف جديد من الملف الأصلي ويضمّن فيه كل المعلومات السابقة.

بينما في الحالة التي تتكلم عنها، أنت تقوم فقط بضغط الـ data ولا تزيدها شئ كما تفعل برامج الضغط ومع هذا سيزداد لديك الحجم.

حتى لا أطيل الحديث كثيراً في الأمور النظرية، أعطني خوارزمية تعمل تقوم بضغط وفك ضغط ملف بالأفكار التي تقترحها يحوي على 16 بايت فقط، لماذا 16 بايت؟ حتى اريحك أيضاً من عملية الـ Padding التي قد تحتاجها. ناقشني بالكود.

Do as I say, not as I do

We are Anonymous. We are Legion. We don't forgive. We don't forget

#17

بســم الله الـرحمــن الرحيــم

السلام عليكــم ورحمـة الله وبركاتــة ،،

اهلا اخي الكريم

الفكرة لا زالت نظرية فهي بالتالي لم تتحول الى خوارزمية بالمصطلح الدقيق فلم تدخل حيز

التطبيق بعد وانتاج كود يقوم بالافكار التي اقترحتها سابقا يحتاج وقت و جهد كبير لا اضنني

اقدر عليه الان فبالتالي لن استطيع توفير خوارزمية لك تقوم بالضغط و الفك حسبما طلبت

ايظا لا اظن حسب علمي ان هنالك خوارزمية تضغط البياتات ذات الحجم الصغير الذي اقترحته علينا

عموما قد تكون لي عودة ان شاء الله تعالى لهذا الموضوع ان جد في الامر جديد

تحياتي

while( "اسلام" )
{
 cout >> "الموت لبني صهيون" >> endl;
}
return "فلسطين";
#18

طيب إن شاء الله وإلى ذلك الوقت إن كان هناك شئ ما قد يخطر لي لمساعدتك سأكتبه لك وبالمثل إن خطرت لك فكرت وإن بدت Crazy شاركنا بها لنناقشك بها.

بالمناسبة، إن كنت قلق من موضوع حجم البيانات الصغيرة فقم بإهماله وابدأ بملف حجمه 1KB مثلاً اجلب محتوياته من أي ملف آخر بواسطة hex editor ثم ابدأ العمل عليه بتروي إلى أن تصل إلى تطبيق الفكرة التي تبتغيها ثم قم بتخفيض الحجم وقم بتعديل الخوارزمية لتتناسب مع الحجم الصغير إلى أن تصل في النهاية إلى قناعة بأنه قد لا يكون هناك إمكانية للضغط أكثر من هذا تستطيع وضع شرط التحقق من الربح بالبايتات الذي تحصل عليه وترى هل هو مجدي بالنسبة للزمن قبل التطبيق.

بالتوفيق وإن شاء الله تصل لمبتغاك.

Do as I say, not as I do

We are Anonymous. We are Legion. We don't forgive. We don't forget

مواضيع مشابهة