السلام عليكم ,
لدي مشروع الان لدعم اللغة العربية في أحد المكتبات ,,
توقفت عند نقطة غريبة جدا !!!
الحروف العربية في جدول اليونيكود مقسمة الى جزئين كما هو واضح في الصورتيين ..
سندرس حرف السين .. على سبيل المثال .
المجموعة الأولى :
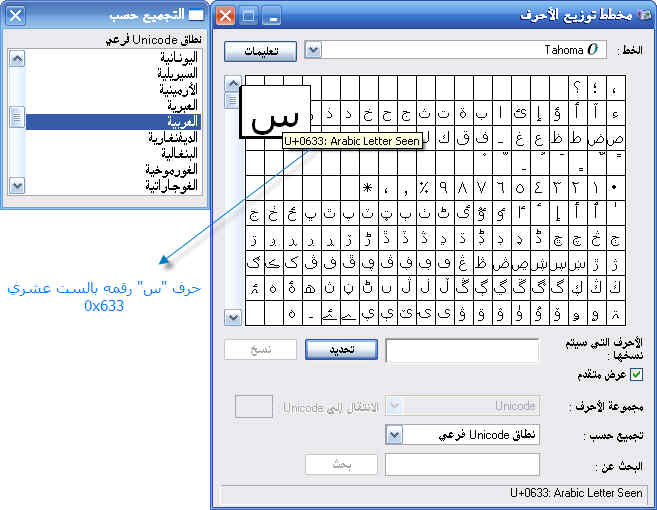
المجموعة الثانية :
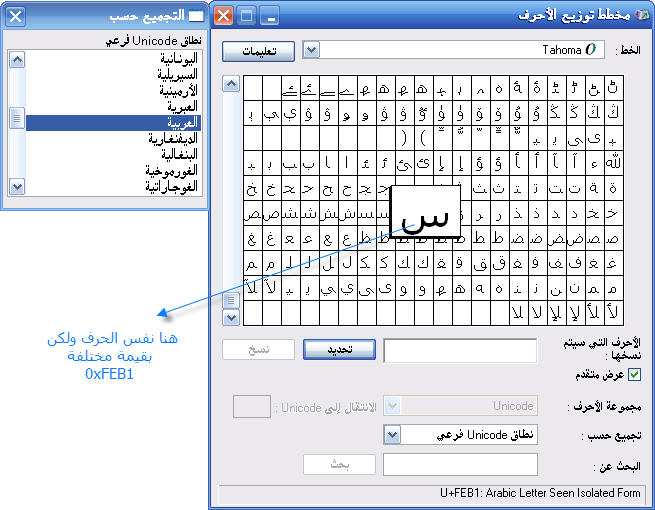
بعد التجارب .. لاحظت أننا لا نستخدم المجموعة الثانية نهائيا ..!!!
مثال :
من المفترض أنه لو كان عندنا هذه الكلمة :
"سسس"
فانه يوجد ثلاثة حروف : "س" - "ـسـ" - " ـس"
ولكن المشكلة انه ليس كذلك ,
أي وحتى لو أننا في اليونيكود .. فاننا نتعامل مع حرف واحد وهو حرف س عادي صاحب الرقم x0633 .
طبقت هذا الكلام في الجافا .. وفي السي بلس .. وكلاهما يعتمد على UTF-16 .
مثال بالسي بلس :
#include<windows.h>
#include<iostream>
using namespace std;

int main()
{
	wchar_t test[]=L"سسس";
	// الان نريد طباعة كل حرف لوحده ..
	for(int i=0;i<3;i++)
		wcout<<(int)test<<endl;

	  /*
	  المخرجات

		1587
		1587
		1587
	  */

	return 0;
}
وفي الجافا :
public class Main {

	public static void main(String[] args) {

		String s="سسس";
		for(int i=0;i<s.length();i++)
			System.out.println((int)s.charAt(i));

		/* Output:
		   1587
		   1587
		   1587
		 */

	}

}
السؤال .. لماذا يطبع نفس الرقم .. أليس من المفترض أنه يطبع ثلاثة ارقام مختلقة لثلاث حروف مختلفة .
اذن السؤال الان :
متى يتم استدعاء الحروف .. ـسـ , ـس .. هل هي خاصة فقط لتطبيقات GUI .. أتمنى يكون السؤال واضح ...