الفريق العربي للبرمجةأرشيف المنتديات · 2000 – 2023
نسخة أرشيفية للقراءة فقط — التسجيل والمشاركة مغلقان، والمحتوى محفوظ كما كان.

الكشف عن العبارات المتطابقة بين نصين

بدأه أبو خالد السوري في 4 مايو 2008 · 4 رد · 1,857 مشاهدة · في JavaSE
مشاركة: واتساب X فيسبوك تيليجرام
#1 صاحب الموضوع

بسم الله الرحمن الرحيم

السلام عليكم

أقدم لإخواني في الفريق العربي للبرمجة هذا البرنامج المتواضع للكشف عن العبارات المتطابقة بين نصين ..
post-152370-1209856736_thumb.png

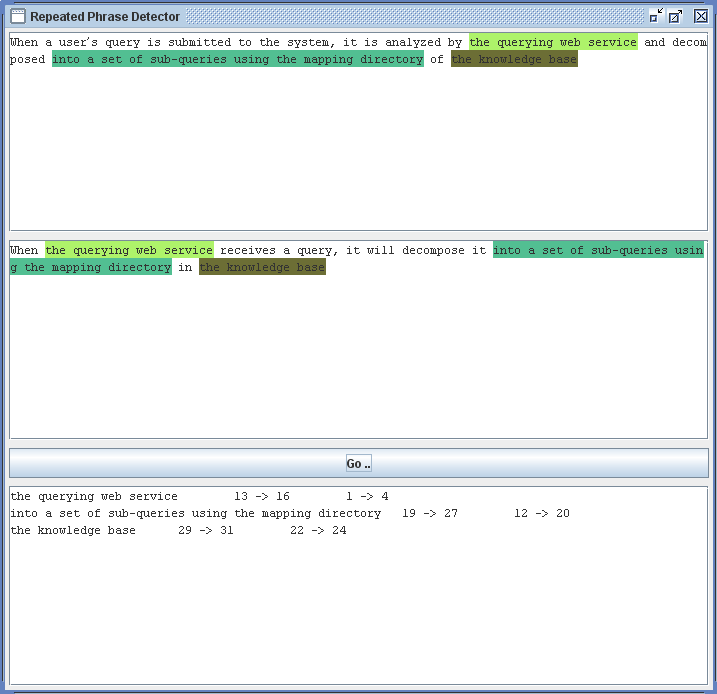
كما هو واضح من الشكل , يقوم المستخدم بإدخال نصين و من ثم الضغط على زر Go ..

فيقوم البرنامج بالبحث عن أي مجموعة من الكلمات ( كلمتان فما فوق) المكررة في كلا النصين و تحديد هذه المجموعات بألوان مميزة ..

و يقوم أيضاً بطباعة هذه العبارات في المربع السفلي مع ترتيب كلماتها في كلا النصين ..

مثلاً : في المثال الوارد في الصورة : العبارة the querying web service

تبدأ في النص الأول من الكلمة رقم 13 إلى الكلمة رقم 16 و في النص الثاني من الكلمة رقم 1 إلى الكلمة رقم 4

(الترقيم يبدأ من الصفر)

البرنامج يدعم اللغة العربية ..

الغاية من البرنامج هي أنني عندما أقوم بإعادة كتابة موضوع ما (تلخيصه مثلاً أو إعادة صياغته) و أريد أن لا أكرر نفس العبارات الموجودة في النص الأصلي ..

فسأحتاج لهذا البرنامج ليخبرني بأماكن وجود التكرار بين ما أكتبه و بين الأصل .. لكي أحاول تلافيها قدر الإمكان ..

يمكن أيضاً استخدام البرنامج للكشف عن حالات الغش/النقل في الامتحانات ذات الطابع السردي (مواضيع الإنشاء/التعبير مثلاً) ..

الملف المرفق يتضمن ملف تنفيذي (.jar) و الملفات المصدرية ..

RPD.rar

سأتحدث عن الخوارزمية المستخدمة لاحقاً إن شاء الله ..

و الآن أترككم مع البرنامج الذي أتمنى أن يعجبكم و أن يحقق لكم الفائدة المرجوة منه ..

في انتظار أرائكم , تعليقاتكم و مقترحاتكم ..

تم تعديل هذه المشاركة بواسطة أبو خالد السوري في 4 مايو 2008 في 02:23

أبو خالد السوري

#2

بصراحة أداة رائعة جداً

واجهتني مشكلة بسيطة

مثال

في الحقل الأول

أنا بحب الفريق العربي

في الحقل الثاني

أنا بحب العربي و بحب الفريق العربي

عندما يقوم بتعليم النص في النصل الأول تجد أنه حصل تضاد

وبالتالي سيقوم بتعليم كلمة بحب باللون خاصة بحب الفريق العربي

أقصد أن المشكلة في نقاط الاشتراك بين النصوص المختلفة

بالنسبة لحل لها

لا يحضرني حل جيد

ربما لو لوناها بلون مختلف عن كليهما

أو لون يدل على أن الكلمة تكررت في أكثر من تشابه

أحببت تنبيهك لا أكثر

تحياتي

حزمة المحرك الإصدارة 0.8

أي أحد يجد أني ظلمته فليراسلني

وبإذن الله لو كان له حق سيأخذه

728x90.png

#3

أسف على رفع الموضوع ولكن الأن شاهدته وبالفعل موضوع مهم جداً ...

أداة جميلة ولكن أرجو إخبارنا عن الخوارزمية المستخدمة لأني منذ مدة بدأت بكتابة برنامج شبيه ببرنامجك وبالجافا أيضاً ولكني لم أكمله ...

لكن برنامجي كان يقارن مقاطع معينة وليس كلمات أي كان يقارن جمل معينة ... كانت بداية الجملة ونهايتها تحدد ب "

أي كلما أجد " أقوم بالبحث عن جملة مشابهة في داتابيز موجودة عندي ... والمقارنة كانت تتم عن طريق تحويل جميع الجمل الأصلية (التي سأحتفظ بها بالداتا بيز) إلى جمل مشفرة 32 بت (هذا يتم لمرة واحدة فقط عند إدخال مقاطع جديدة إلى الداتا بيز فأشفرهم وأرسل النص المشفر إلى الداتا بيز) والجمل التي سأقارنها والتي تحدد بدايتها ونهياتها ب " أيضاً أشفرها وأقارن النصين المشفرين وهكذا ستكون المقارنة أسرع بكثير مما لو قارنت حرف حرف ...

هذه أفضل ما توصلت إليه ... هل لديك طريقة أسرع أخي الكريم

#4

أهلاً بك أخي خالد الحوراني ..

فيما يلي شرح الخوارزمية المتبعة في برنامجي ..

خوارزمية الكشف عن العبارات المتطابقة بين نصين :

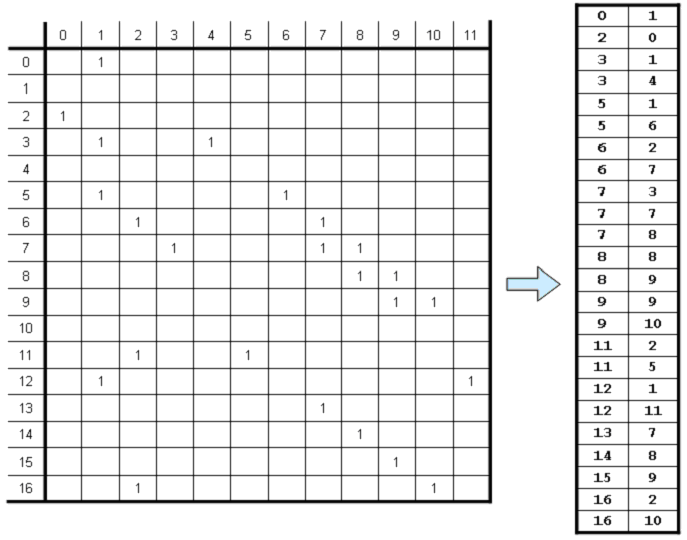
1) تحليل النصين (phras1 و phras2) إلى مجموعتي كلمات و وضعهما في مصفوفتين words1 و words2

String[]  words1 = phras1.split(" ");
String[]  words2 = phras2.split(" ");

2) مقارنة عناصر المصفوفتين كلمة بكلمة .. و في حال تطابق كلمتين نقوم بتخزين إحداثياتهما (ترتيب كل منهما في مصفوفته) في مصفوفة جديدة matchs

Vector<Point> matches = new Vector<Point>();
for (int i = 0; i < words1.length; i++) {
	for (int j = 0; j < words2.length; j++) {
		words1 = words1.trim();
		words2[j] = words2[j].trim();
		if(words1.equalsIgnoreCase(words2[j])){
			Point p = new Point(i,j);
			matches.add(p);					
		}
	}
}

post-152370-1213134232_thumb.png

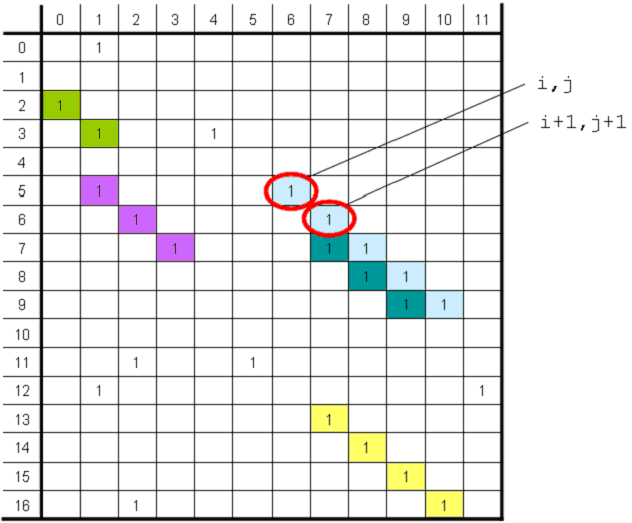
3) في هذا الجدول نقوم بالبحث عن السلاسل المترابطة قطرياً .. (السلاسل الملونة في الشكل التالي)

نبدأ بالمرور على عناصر المصفوفة matchs و التي هي عبارة عن ثنائيات (point)

و عند كل ثنائية (i,j) ننشئ سلسلة جديدة نضع فيها هذه الثنائية فقط (مبدئياً)

ثم نتحقق فيما إذا كانت الثنائية التالية لها قطرياً (i+1,j+1) تنتمي إلى المصفوفة matchs أم لا

فإن كانت تنتمي ( أي الثنائية (i+1,j+1) ) نقوم بإضافتها إلى السلسلة الخاصة بالثنائية (i,j) و نحذفها من المصفوفة matchs

ثم ننتقل إلى الثنائية التالية لهما قطرياً (i+2,j+2) و نتحقق من كونها تنتمي إلى المصفوفة matchs أم لا

فإن كانت تنتمي أضفناها إلى السلسلة و حذفناها من المصفوفة matchs

و هكذا نتابع تجميع الثنائيات المتجاورة قطرياً في سلاسل

post-152370-1213134242_thumb.png

طبعاً عملية الحذف لا تتم بشكل فعلي على عناصر المصفوفة matchs لكي لا يختل ترتيب العناصر فيها

و إنما تتم من خلال استخدام مصفوفة اسمها removed نخزن فيها الثنائيات المحذوفة من المصفوفة matchs

الغاية من الحذف هي تجنب الحصول على سلاسل مكررة في سلاسل أوسع منها

مثلاً : لتكن السلسلة الفعلية هي chicken ran away , لا نريد الحصول على سلاسل جزئية مثل ran away

عملية التحقق من الثنائية التالية قطرياً تتم باستخدام التابع checkNext

public void checkNext(Point p, Vector<Point> chain){
	Point next = new Point(p.x+1,p.y+1);
	if(matches.contains(next)){			
		chain.addElement(next);
		removed.addElement(next);
		checkNext(next, chain);
	}
}

بعد الانتهاء من عملية إيجاد السلاسل نأخذ بالاعتبار فقط السلاسل التي تحوي على أكثر من ثنائية ..

السلسلة التي تحوي ثنائية واحدة فقط تعني أنها تحوي كلمة واحدة فقط (المكررة في النصين) .. و هكذا سلسلة لا تهمنا ..

فيما يلي الكود الخاص بالبحث عن السلاسل ضمن المصفوفة matchs

Vector<Vector<Point>> series = new Vector<Vector<Point>>();
Iterator<Point> iter = matches.iterator();
while (iter.hasNext()) {
	Point p = iter.next();
	if(!removed.contains(p)){
		Vector<Point> chain = new Vector<Point>();
		chain.addElement(p);
		checkNext(p,chain);
		if(chain.size()>1){
			series.addElement(chain);
		}
	}			
}

حيث series هي مجموعة كل السلاسل التي تم الكشف عنها (تحوي ثنائيتين على الأقل) و هذه هي المجموعة التي سيتم إخراجها للمستخدم ..

أرجو أن يكون الشرح واضحاً ..

أبو خالد السوري

#5

شكراً أخ أبو خالد على التوضيح ولكن لي تعليق:

1- الخوارزمية المستخدمة (أقصد خوارزمية البحث) من أكثر الخوارزميات استهلاكاً للموارد ... وتعقيدها من مرتبة 2^n (أي 2 أس عدد مواقع المصفوفة)

2- يمكن تطويرها كثيراً لتصبح مثالية والحل الذي ذكرته في ردي السابق هو من أفضل الحلول التي وجدتها

3- يوجد برنامج قديم ومازال مستخدماً حتى الأن في اللنكس وشارك بكتابته عمالقة البرمجة (Douglas McIlroy, Alfred Aho, Jeffrey Ullman)

http://en.wikipedia.org/wiki/Diff

استفدت منه كثيرأ ... فـأرجو منك أن تطلع عليه فهو مفتوح المصدر

مواضيع مشابهة

عدد الزوار حالياً

المتواجدون خلال آخر دقيقتين · يتحدّث كل ٣٠ ثانية

—الإجمالي—أعضاء مسجّلون—زوار بدون تسجيل

جارٍ التحقق من المتواجدين…