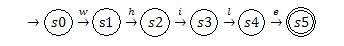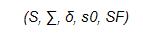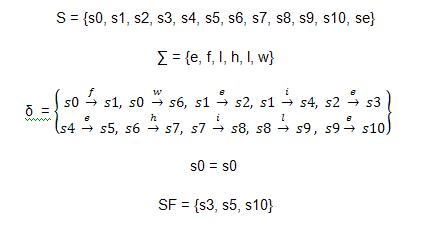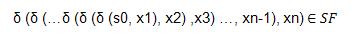بسم الله الرحمن الرحيم
الدرس الثاني في بناء وهندسة المترجمات
القسم الأول
إندكس :
1/ مقدمة إلى المسح
2/ التعرف على الكلمات
3/ صياغة صورية لأنظمة التعرف
4/ التعرف على كلمات وأرقام أكثر تعقيداً
1/ مقدمة
- ذكرنا في الدرس السابق أن وظيفة الماسح هي : المرور على الشيفرة البرمجية ومعرفة هل الكلمات المستخدمة موجودة في مفردات اللغة أم لا .
- يقوم الماسح (محلل المفردات) بأخذ تدفق من النصوص كدخل له , ويخرج تدفقاً من الكلمات مرفقة مع صنوفها التركيبية القواعدية . ويقوم بتجميع الرموز لتشكيل كلمات ويطبق مجموعة من القواعد لتحديد فيما إذا كانت كل كلمة صحيحة في اللغة المصدر . إذا كانت الكلمة سليمة , يقوم الماسح بإرفاقها مع صنفها التركيبي القواعدي أو جزء الكلام الذي تنتمي إليه , مثال :
دخل = For
خرج = (For ,Start Loop)
- ويقوم الماسح أيضاً بتجميع المحارف ضمن كلمات بحيث يستطيع المحلل معالجة كل كلمة كرمز , مما يقلل عدد الكلمات التي يعالجها المحلل .
- إن القواعد التي تحكم بنية المفردات للغة برمجة, والتي تدعى أحياناً الصيغة القواعدية الصغرية (Microsyntax) هي بسيطة ومنتظمة, الأمر الذي يقود إلى أنظمة تعرف متخصصة فعالة للمسح.
- تعتبر الأنواع الثلاثة المكونة للنهاية الأمامية (المسح , التحليل , التحليل الحساس للسياق) من المهام المنفصلة من حيث المبدأ , ولكنها عملياً غالباً ما تعمل بطريقة متشابكة . حيث يقوم المحلل باستدعاء الماسح لإنتاج كلمات مصنفة عند الطلب ويقوم بالاعتماد على التحليل الحساس للسياق عندما يتعرف على أجزاء فرعية قواعدية مختلفة ضمن الشيفرة. تشكل تلك المحللات مجتمعة النهاية الأمامية .
- يفيد الفصل بين الصيغة القواعدية والصيغة القواعدية الصغرية إلى تصغير المترجم بثلاثة طرق :
1) تتم كتابة وصف الصيغة القواعدية المستخدمة من قبل المحلل على شكل كلمات وأصناف تركيبية قواعدية بدلاً من الأحرف والأرقام والفراغات. يسمح هذا للمحلل بتجاهل الأمور التي ليس لها معنى مثل الفراغات الإضافية و محارف الأسطر الجديدة والتعليقات, تكون هذه الأمور مخفية داخل الماسح حيث يتم التعامل معها بشكل نظيف وفعال.
2) إن بناء الماسح هو عملية مؤتمتة بالكامل (أي أنها ذاتية العمل) تقريباً , حيث يتم ترميز قواعد مفردات اللغة بتدوين صوري وتسليمها لمولد الماسح, وتكون النتيجة برنامجاً تنفيذياً يقوم بإعطاء الدخل للمحلل. وتكون المحللات الناتجة من توصيفات ذات مستوى عالي فعالة.
3) يؤدي نقل كل قاعدة داخل الماسح إلى تصغير المحلل. يعتبر التحليل أصعب من المسح, حيث يزداد حجم المحلل مع زيادة القواعد. يساعد تصغير المحلل في تقليل الجهد اللازم لبناء المترجم وذلك لأن بناء المحلل يحتاج جهداً مباشر أكبر من قبل المبرمج .
2/ التعرف على الكلمات :
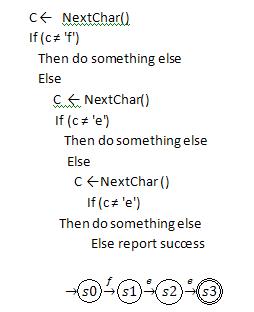
لنأخذ مثلاً مسألة التعرف على كلمة fee , ولنفترض وجود إجراء اسمه NextChar يقوم بإرجاع الحرف التالي , يمكن أن تظهر الشيفرة بهذا الشكل عند استخدام تركيب If..Then..Else :

تقوم الشيفرة السابقة باختبار f ثم e ثم e , ويؤدي الفشل في مطابقة المحرف الملائم عند كل خطوة إلى قيام الشيفرة برفض السلسلة والقيام بشيء آخر. (إذا كان الغرض الوحيد من لبرنامج هو التعرف على الكلمة fee فسيكون التصرف الملائم هو طباعة رسالة خطأ , لكن الماسحات نادراً ما تقوم بالتعرف على كلمة واحدة فقط كما سنرى إن شاء الله , ولذلك سنترك معالجة الخطأ الآن).
تمثل s0 , s1 , s2 , s3 حالات مجردة للحساب , ومرقمة من الصفر إلى الثلاثة , تسمى الحالة ذات الرقم صفر بحالة البداية , والحالة التي داخل دائرة مزدوجة فستسمى حالة النهاية.
(s هي اختصار لـstate)
يمكننا بنفس الخوارزمية ترميز عملية التعرف على كلمة while مثلاً , على شكل سلسلة من خمس بنى if..then..else متداخلة. سنقوم فقط بعرض مخطط الانتقالات لأن الشيفرة ستكون صعبة القراءة :

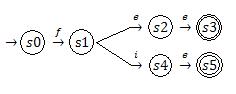
يمكننا استبدال do something else بأوامر للتعرف على المزيد من الكلمات , مثلاً , لنتعرف على fee و fie نتبع المخطط التالي :

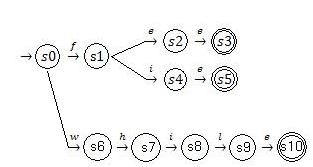
يمكننا تركيب القطعة السابقة للتعرف على fee , fie , while عن طريق دمج حالاتها الابتدائية وإعادة ترقيم بقية الحالات حسب الحاجة. يؤدي هذا إلى المخطط التالي :

3/ صياغة صورية لأنظمة التعرف :
تمثل المخططات السابقة تجريدا للشيفرة اللازمة لتحقيق تلك الانتقالات , ويمكن رؤيتها ككائنات رياضية صورية تدعى الأوتومات المنتهية (Finished Automata) (FA) وهي التي توصف نظام التعرف . تتشكل الأوتومات المنتهية من مجموعة منتهية من الحالات , ومجموعة من الانتقالات بين تلك الحالات وأبجدية وحالة ابتدائية (s0) وحالة نهاية أو أكثر . يتم تمثيل الأوتومات المنتهية على الشكل التالي :

حيث أن :
S هي مجموعة الحالات المستخدمة , مثلاً s1 , s2 , s5 وأيضا حالة الخطأ التي تعرف بـse
(الحالات الأخيرة والأولى لا توضع في S)
الرمز الثاني هو الأبجدية أو الحروف المكونة للكلمات المستخدمة , مثلا الحروف المستخدمة في المثال السابق هي :
{f,e,e,f,I,e,w,h,i,l,e} , إذا الأبجدية تصبح {f,e,l,w,h,i}
الرمز الثالث يأخذ وسيطين s و c حيث s هو الحالة (s2,s5) وc هو حرف (f, e, w)
وعند الوصول إلى الحرف الموجود في c والحالة الموجودة في s يتم استدعاء هذا الرمز
S0 هي حالة البداية
SF هي مجموعة حالات النهاية , وهي في المثال السابق = s3 , s5 , s10
لجعل التمثيل أوضح , انظر الصورة التالية :

تكافئ هذه الخماسية مخطط الانتقالات ويمكن بناء أحدهما بالاعتماد على الآخر ,
مثال :
إذا كانت السلسلة النصية x مكونة من محارف x1x2x3…xn فستقبل قاعدة الأوتومات السابقة السلسلة x إذا كان :

في المثال السابق , كلما وجد أن حالة ما صحيحة , ينتقل إلى التي تليها , وهكذا ...
هناك حالتين للخطأ في المثال السابق :
أ) أن يصادف خطأ قبل الوصول إلى xn عندها يجب عرض رسالة خطأ وااااضحة.
ب) أن يصادف الخطأ في xn نفسها , عندها يعرض خطأ أن الكلمة قد تكون صحيحة لكنها ناقصة
4/
التعرف على كلمات اكثر تعقيداً
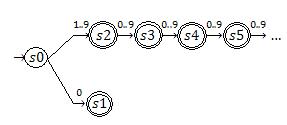
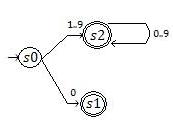
العدد الصحيح في البداية هو :"العدد المشكل من صفر أو من سلسلة من رقم واحد أو أكثر حيث الرقم الأول هو بين الواحد والتسعة وبقية الأرقام من صفر إلى تسعة"
كيف يمكن رسم مخطط انتقال لهذا التعريف ؟

فكر في المشكلة الكبيرة التي في هذا المخطط , هل عرفتها ؟
إنها أن هذا المخطط غير منتهي , وهذا يخالف متطلبات الأوتومات المنتهية , التي تحتوي عددا منتهياً من الحالات .
لذا سنبدأ في استخدام الدوارات
يمكن تبسيط المثال السابق من خلال استعمال :

إلى هنا ينتهي الدرس , لمزيد من المعلومات راجع موضوعي الخاص بالأمثلة والتطبيق العملي , أو ضع استفسارك هنا