الفريق العربي للبرمجةأرشيف المنتديات · 2000 – 2023
نسخة أرشيفية للقراءة فقط — التسجيل والمشاركة مغلقان، والمحتوى محفوظ كما كان.

تطبيق فكرة الserialization في السي بلس.

مغلق
بدأه Abdullah.Alshammeri في 3 فبراير 2008 · 11 رد · 2,268 مشاهدة · في لغة C و ++C
مشاركة: واتساب X فيسبوك تيليجرام
#1 صاحب الموضوع

السلام عليكم ,

توجد هذه الفكرة في الجافا .. حبيبتي ...

وبحثت عن كيفية تطبيق هذه الفكرة في السي بلس ,,

اولا الهدف من الSerialization , وترجمته بالنشر المتسلسل ...

هو كتابة كائن Object الى File .. حيث نكتب بيانات الObject والتي هي int و float الخ .. الى الفايل .

بدلا من أن نكتب

Object j;
File f;
f.writeInt(j.x);
f.writeFloat(j.z);
f.writeString(j.name);

نسوي كذا:

Object obj(10,"Name",5.5);

File f....
f.writeObject(obj);

ونستفيد من Serialization في الشبكات حسب ما قرأت

فالسؤال هنا ... كيف يمكن تطبيق هذه الفكرة .. في السي بلس .. هل يوجد مشروع جاهز لعمل ذلك ؟؟

او هل توجد دالة في المكتبات القياسية .. تؤدي هذه المهمة !!

اللي أعرفه وحسب ما قرأت في أحد الفكرة .. هو أننا نعمل واجهة interface اسمها مثلا Serialization

تحتوي على دالة WriteObject .. واذا اردنا كائن معين يستفيد من هذه الخدمة .. فاننا نعمل implementation .. مثال:

class Serialization
{
public:
virtual void writeObject(File* f)=0;
};

class Object :public Serialization
{
int x,y;
float z;
char* name;
.
.
.
public :
virtual void writeObject(File *f)
{
f.writeInt(x);f.writeInt(y);f.writeFloat(z);....
}
};

main()
{
	File*f=new File();
	Object* j=new...
	j.writeObject(f);
}

هل توجد طريقة أفضل .... هل يوجد مشروع أحد جربه ويفيدني ...

وهل كلاسات الSTL تدعم خاصية Serialization ...

تم تعديل هذه المشاركة بواسطة الشمري في 3 فبراير 2008 في 23:52

logo1.png تطبيق طمأنينة ، نسخة بيتا على أندرويد

عبدالله الشمّري - Al-Shammari

CodingAlone.com

twitter @abshammeri

abshammeri AT gmail.com

github : abshammeri

#2

يوجد دعم في مكتبة MFC لل Serialization عن طريق الكلاس CObject

راجع مكتبة MSDN عن CObject لمزيد من المعلومات ........

#3

السلام عليكم و رحمة الله و بركاته,,

أخي الشمري, أقرأ عن هذا الموضوع منذ زمن, و هو من أحب المواضيع إلى قلبي, أعطني يوماً أو يومين حتى أجهز الردود المفصلة B)

الموضوع رائع, ولا غنى لأي مبرمج عن تعلم هذه التقنيات,

انتظرونا :rolleyes:

تحياتي ,,

تم تعديل هذه المشاركة بواسطة Khaled.Alshaya في 5 فبراير 2008 في 00:32

#4
اقتباس
هل توجد طريقة أفضل .... هل يوجد مشروع أحد جربه ويفيدني ...

حقيقة هو موضوع جميل جدا في عالم C++ ..

ومدام خالد قال ..

اقتباس
أعطني يوماً أو يومين حتى أجهز الردود المفصلة

اذا اترك له المجال لكي يبدع كابداعاته المستمره دائما .. فليس لدي الفرصه الان للكتابه ..

ننتظر شرحك خالد لتثري معلوماتنا ..

تحياتي العطرة ..

يَارَبُ إِن ضَاقَت قُلُوُب الْنَّاسٍ عَنْ مّافِي .. مِنْ خَيْرٍٍ فَعَفْوكَ لَا يَضِيْقْ ..

#5

السلام عليكم ,,

عذراً أخي الشمري على التأخير,

ما رأيك أن نلقي نظرة عامة على الـ Serialization قبل أن ندخل في تفاصيله, حتى يكون كلامنا عن أمثلة بسيطة.

بداية, يمكن القول بأن الـ Serialization هو طريقة تحويل البيانات الموجودة في في برنامجنا, بحيث تصبح بيانات ذات هيأة معروفة في برنامجنا أو برنامج آخر معد للتعرف على تلك الهيأة, كمثال على ذلك, أن نقوم بكتابة تلك البيانات للقرص الصلب أو إرسالها عن طريق الشبكة,

طبعاً, كلامنا سيكون على كتابة البيانات للقرص الصلب فقط لتبسيط المناقشة.

كما تعلم أن المتغيرات الموجود في برامجنا, عبارة عن أوعية لحمل البيانات المهمة لدينا! هذه المتغيرات, لها هيأة معينة (نوع المتغير هو هيأته),

و دون معرفة تلك الهيئة لن تفيدنا تلك البيانات في حالتها الخام!

الـ Serialization ما هو إلا الطريقة التي سنتبعها, في تخزين تلك البيانات, عندما تكون خارج برنامجنا!

كما تعلم أن أي برنامج, يتم تحميله لذاكرة الحاسب, و عند انتهائه يتم التخلص منه,

بالتالي, لا يمكن أن يبقى برنامجنا في الذاكرة طوال الوقت, لكي يحافظ على بياناته.

ما هي الطريقة التي سيستخدمها في حفظ تلك البيانات دون الإخلال بهيأتها! هو ما يسمى بالـ Serialization.

أتمنى أن المقدمة كانت كافية لإلقاء نظرة على هذا الموضوع الجميل,

و لكن لننظر نظرة أعمق على البيانات في ++C, حتى نحصل على الفائدة المرجوة.

هناك أنواع أولية, و هناك أنواع مركبة كالـ union و الـ struct و الـ class,

الأنواع البسيطة هي الأنواع التي ستشغل اهتمامنا في عملية الـ Serialization, أما عملية الـ Serialization للأنواع المركبة, فهي بكل بساطة, عملية Serialization لمجموعة من المتغيرات ذات الأنواع البسيطة, و لكن تلك العملية تتم على مجموعة من تلك المتغيرات التي سيتم معاملتها كمجموعة بدلاً من أفراد, هذه العملية يجب أن تتم بشفافية و أن يتم معاملة الـ class مثلاً على أنها نوع بسيط بدلاً من معاملتها على أنها مركبة من عدة متغيرات بسيطة!

حسناً بما أننا وصلنا لهذه النقطة, يمكنك القول بأن أي File Format هو عبارة عن Serialization Specification لذلك النوع من الملفات,

على سبيل المثال, إذا قلنا بأن أول four bytes هي عبارة عن متغير من نوع unsigned int يحمل ذلك المتغير حجم الملف, فنحن قمنا بوضع Specification للملف, و قمنا بتعريف نوع أول four bytes بالإضافة لتعريف قيمتها أو ظيفتها!

للأسف, ++C توفر Low Level Functions فقط للتعامل مع الملفات. تلك الدوال هي دوال أساسية للتعامل مع الملفات دون الدخول في تفاصيل عتاد الحاسب.

تلك الدول مصممة أصلاً لكي نبني فوقها دوال للتعامل مع الملفات, و بالتالي يصبح لدينا High Level Functions يمكننا استخدامها في مشروعنا,

صحيح أننا نرى تلك الدوال تستخدم مباشرة في كثير من الأكود التي نراها, و لكن تذكر أن معظم ما نراه هو أمثلة و ليس برامج كاملة!

طبعاً هناك حلان لكي نقوم بعملية Serialization لمجموعة من البيانات.

الحل الأول أن نتعامل مع الملفات على أنها ملفات خام. أو بمعنى اصح أن نتعامل معها بالـ Binary Mode.

و الحل الثاني أن نتعامل معها على بالـ Text Mode.

الفرق بين الطريقتين ليس بسيطاً كما يبدو لأول وهلة, بل هو سبب حرب قائمة في عالم الحاسوب, رغم أن معظم المبرمجين يفضلون الحل الثاني,

في المرة القامة بإذن الله سنستعرض الحل الأول, لأنه الأسهل! و لكننا بكل تأكيد سنتعرف على مساوئ التعامل مع الملفات على أنها Binary Data, و سنتعرف على المزايا.

سيتبع ذلك, التعرف على التعامل مع الملفات على أنها Text Files, و ماهي مزايا هذه الطريقة و ما هي عيوبها,

و لماذا يفضلها المبرمجون عادة :)

بعدها, عندما نكون قد اكتفينا من النظري, سنتكلم بشكل موجز بإذن الله عن المكتبات الشهيرة في هذا المجال و طرق الـ Serialization القياسية,

تحياتي ,,

#6

السلام عليكم ,,

في نهاية الرد السابق ذكرت طريقتين لكتابة البيانات للقرص الصلب :

Text Mode : رغم أن معظم الكتب تبدأ بهذه الطريقة إلا أن هذه هي الطريقة المتقدمة أو الطريقة التي تحتاج إلى توضيح!

Binary Mode : الوصول المباشر للبيانات! هذه أسهل طريقة للوصول للبيانات! و ستلاحظ عيوبها !

من رأيي أن نأخذ مثالاً نطبقه على الطريقتين, لنلاحظ الفروق بينهما.

لو تخيلنا أن بيانات نافذة على الشاشة :

struct Properties{
	int x, y;
	int width, height;
};

كما تلاحظ في الـ Struct السابق لدينا أربعة عنصر, كل عنصر عبارة عن عدد صحيح حجمه 4 bytes.

لو أردنا حفظ البيانات لملف, كي نسترجع تلك البيانات عند عمل البرنامج من جديد, كما تفعل معظم البرامج! ستجد مع معظم البرامج ملف يسمى configuration أو config أو ini. إلى آخر المسميات على حسب المبرمج نفسه!

لو أردنا كتابة تلك المعلومات للملف, فكل ما سنقوم به هو التالي :

#include <fstream>

struct Properties{
	int x = 100, y = 200, width = 300, height = 400;
};
int main(){

	Properties prop;
	prop.x = 100;
	prop.y = 200;
	prop.width = 300;
	prop.height = 400;

	ofstream binFile( "test.bin", ios::binary );
	binFile.write( reinterpret_cast<char*>(&prop), sizeof(prop) );
	binFile.close();

	return 0;
}

كما تلاحظ, عرفنا مجموعة من الأعداد الصحيحة على شكل struct, حجمه 16 bytes,

المتغيرات في الذاكرة ستكون متجاورة, لذلك سنقوم بكتابة الـ struct كله مرة واحدة للملف.

كل ما عليك فعله لاستعادة المعلومات من الملف هو التالي :

Properties prop;
ofstream binFile( "test.bin", ios::binary );
binfile.read( reinterpret_cast<char*>(&prop), sizeof(porp) );
binFile.close();

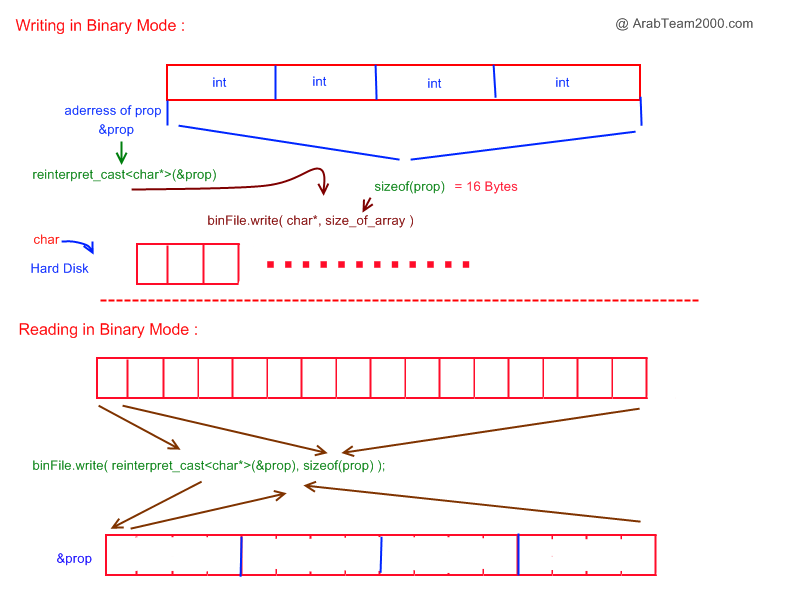
دالتي القراءة و الكتابة, تتعاملان مع مصفوفة من البيانات, أي أن البيانات حين يتم كتابتها يتم كتابتها على شكل bytes.

مارأيك بصورة توضح عملية القراءة و الكتابة حتى يكون الموضوع أكثر وضوحاً.

post-89451-1202492805_thumb.png

لاحظ معي, عند عملية الكتابة, تتم كتابة البيانات كلها, على شكل مصفوفة bytes لأنها أصغر وحدة تخزين في ++C/C, و في اللغات الأخرى عموماً.

لاحظ أيضاً أننا قمنا بإعطاء دالة الكتابة عنوان الـ Struct على شكل *char, ثم أرسلنا حجم هذه المصوفة, يمكن أن تسمي العملية بالكتابة العمياء :lol:

أي أن الدالة تقوم بكتابة أي شيء يبدأ عند العنوان الفلاني لعدد محدد من الـ bytes.

هل رأيت السهولة, لقراءة struct! ستجد في المرفقات كائن BMP قمت بكتابته منذ مدة لتحميل صورة إلى الذاكرة, الكائن ليس مكتملاً, و لكن عمليتي تحميل و حفظ الصورة مكتملتين, مع امكانية معرفة بعض خصائص الصورة, يمكن إضافة الكثير من الدوال له بسهولة لأن الصورة ستكون في الذاكرة, و حجم الصورة لدينا و الكثير من المعلومات الجاهزة التي يقوم بعملها الكائن.

إذا اطلعت على عمليتي القراءة و الكتابة في الكائن, ستجد أننا قسمنا القراءة و الكتابة على مرحلتين!

هذه أولى المشاكل التي يمكن أن تظهر لك!

سنناقش بعض مشاكل الملفات الخام, و لكن ليس الآن :)

تحياتي ,,

StegIt.rar

تم تعديل هذه المشاركة بواسطة Khaled.Alshaya في 8 فبراير 2008 في 20:57

#7

السلام عليكم ,,

سننظر الآن لبعض عيوب التعامل مع الملفات بواسطة الـ Binary Mode,

كما ذكرنا سابقاً, عندما نقرأ مجموعة من الـ bytes من القرص الصلب, فإن المعالج يقوم بعملية نسخ دون أدنى تعديل, و يضع الـ bytes في المكان الذي نريده في الذاكرة,

جميل أليس كذلك ؟ و لكن هل هناك مشاكل لهذه الطريقة ؟

حسناً لنستعرض إحدى تلك المشاكل,

تصور أن برنامجك تمت ترجمته على منصتين, الأولى من Intel و الثانية من Motorola,

(أجهزة Mac كانت لفترة قريبة تستخدم منصات Motorola بالمناسبة ),

و قمنا بإنشاء ملف يحتوي على الـ Properties التي تكلمنا عنها في الرد السابق, على منصة Intel,

بعد ذلك قمنا بنقل هذا الملف, لمنصة Motorola, لكي يأخذ البرنامج البيانات منه, و يستفيد منها,

حسناً, لا تتوقع الكثير سوى أن برنامجك الموجود على منصة Motorola سيقرأ بعض الـ Garbage!!

السبب بالطبع يرجع لاختلاف بنية المنصتين, و الخاصية التي نتكلم عنها هي ما يسمى بالـ Endianness,

بكل بساطة, كيف سيقوم المعالج بقراءة و كتابة البيانات للذاكرة داخلياً!

هناك عدة طرق تستخدمها المعالجات, و لكن أشهرها طريقتين يمكن لك القراءة حولها لتعرف التفاصيل أكثر,

الطريقة الأولى, تستخدمها منصات Intel, و تسمى Little-endian

الطريقة الثانية, تستخدمها منصات كـ Motorola, و تسمى Big-endian

حتى يتضح الموضوع أكثر, لنأخذ مثالاً, و ليكن السطر التالي من الرد السابق :

prop.x = 100;

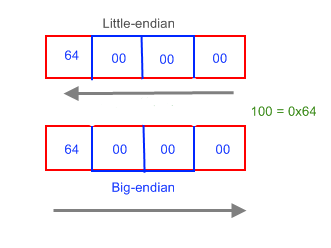
قمنا بإسناد العدد 100 للمتغير x و الذي يعتبر من النوع int و حجمه 4 bytes في معظم المنصات الموجودة حالياً ( 32bit ),

الصورة التالية توضح كيف سيكتب معالج Intel العدد للذاكرة, و كيف سيقرأ معالج Motorola العدد من الذاكرة!

post-89451-1202679014_thumb.png

في المنصات التي تستخدم little-endian سيتم قراءة أول byte من اليسار على أنه الـ byte الأصغر, و بالتالي فقيمة العدد حينما كتبناه كانت 100,

أما في المنصات التي تستخدم big-endian سيتم قراءة أول byte من اليسار على أنه الـ byte الأكبر و بالتالي فقيمة العدد حين قراءته ستصبح :

0x64000000 = 1677721600 !!!!!!!!!!

هل رأيت المشكلة التي ظهرت, بالطبع هناك حلول كثيرة, و لكنها قد تكون أكبر من البرنامج الذي نقوم بتصميمه!

إذا أردت الاستزادة يمكنك قراءة المقال التالي, فهو أكثر من رائع :

War of the Worlds: Endianness

نتطرق الآن للمشكلة الثانية, و تسمى Data Alignment, كنت قد فتحت موضوعاً منذ مدة حول الموضوع يمكنك الرجوع إليه :

الأسمبلي في كل مكان حتى في ++c !

أترككم في رعاية الله, وفي انتظار المناقشة, قبل أن نتكلم عن الـ Text Mode,

تحياتي ,,

#8

السلام عليكم ,,

رائع أخوي خالد .. مكتبة السي بلس القياسية لم تخذلني كما توقعت :D .. والمشاكل التي ذكرتها :

اقتباس
هل رأيت المشكلة التي ظهرت, بالطبع هناك حلول كثيرة, و لكنها قد تكون أكبر من البرنامج الذي نقوم بتصميمه!

قرأت عن الBig-endian و little-endian سابقا ..وسبق وان سألت عنها في هذا المنتدى ,,

الحل سهل .. اذا كانت مسألة كتابة بايت واحد .... قبل ان نكتب البايتات نشيك على النظام .. ونعرف كيف نكتب البايت .. لكن المشكلة أن الSTL هي اللي تقوم بالكتابة .. لذلك الحل .. هو أننا نبتدع طريقة خاصة بنا لكتابة الObject وفي قلب برنامجنا .. يكون فيه دالة اسمها writeByte وهي اللي تختلف بين كل نظام ... هذا ما اعتقده :-)

أنا بدأت بكتابة الكود .. وأحتاج لبعض الوقت ,,,

logo1.png تطبيق طمأنينة ، نسخة بيتا على أندرويد

عبدالله الشمّري - Al-Shammari

CodingAlone.com

twitter @abshammeri

abshammeri AT gmail.com

github : abshammeri

#9

اهه ... كنت اتوقع المشكلة في كتابة بايت ...

الان الملفات التي نكتبها في المفكرة ونحفظها ... ماتطلع بشكل صحيح في الماك ... الا اذا حفظناها بطريقة big-endian،

اذا مالفرق بين مشروعنا ومايكروسوفت .... لا توجد مشكلة ان شاء الله ,, فلتنغاضى عن مشكلة البايت وطريقة تخزينه ...

خلاص حلينا المشكلة الأولى :P .

المشكلة الثانية .. أيضا مشكلة ( وفسر الماء .. بعد الجهد بالماء ) ,,

ولكن أليس الSTL تكتب البيانات بشكل صحيح .. حسب ماجربت .. والله شكل الأمور تعقدت :(

logo1.png تطبيق طمأنينة ، نسخة بيتا على أندرويد

عبدالله الشمّري - Al-Shammari

CodingAlone.com

twitter @abshammeri

abshammeri AT gmail.com

github : abshammeri

#10

السلام عليكم ,,

أخ الشمري, أنا لم أفصل كثيراً في موضوع الـ Endianness,

المشكلة لا تتوقف عند ترتيب الـ Bytes بل تمتد لترتيب الـ Bits فكلاهما يفسر الـ Most Significant Bit بشكل معكوس,

عموماً أنا آسف لأني لم أكتب حتى الآن حول الـ Text Mode و لكن عن قريب بإذن الله سنتكلم عنها,

بالمناسبة ماذا تقصد بـ :

اقتباس
ولكن أليس الSTL تكتب البيانات بشكل صحيح .. حسب ماجربت .. والله شكل الأمور تعقدت

لا أدري, ماهو الشيء الذي تتكلم عنه في STL ؟

تحياتي ,,

تم تعديل هذه المشاركة بواسطة Khaled.Alshaya في 12 فبراير 2008 في 09:36

#11

عفوا ... أقصد ال c++ io stream .. المعذرة .. ما نمت من أمس ...

logo1.png تطبيق طمأنينة ، نسخة بيتا على أندرويد

عبدالله الشمّري - Al-Shammari

CodingAlone.com

twitter @abshammeri

abshammeri AT gmail.com

github : abshammeri

#12

وجدت مشكلة أخرى :D .. وهي مع الكلاس الذي يحوي virtual function ... حيث سيتم أخذها في الحسبان عند كتابتها في الفايل .. حيث سيزداد حجم الملف 4 بايت في حال وجودة دالة virtual ... حيث سيزداد حجم الملف بدون فائدة .

من كتاب C++ Primer ...

fout.write( (char *) &pl, sizeof pl);

This statement goes to the address of the pl structure and copies the 36 bytes (the value of sizeof pl expression) beginning at this address to the file connected to fout.

To recover the information from a file, use the corresponding read() method with an ifstream object:

ifstream fin("planets.dat", ios_base::binary);
fin.read((char *) &pl, sizeof pl);

This copies sizeof pl bytes from the file to the pl structure. This same approach can be used with classes that don't use virtual functions. In that case, just the data members are saved, not the methods. If the class does have virtual methods, then a hidden pointer to a table of pointers to virtual functions also is copied. Because the next time you run the program it might locate the virtual function table at a different location, copying old pointer information into objects from a file can create havoc

بالنسبة للمشاكل التي ذكرها الاخ خالد .. فبعد التجارب التي أجريتها تبيّن لي التالي :

1- مشكلة الBig-Endian وlittle-Endian ... ممكن نتجاهلها ..

2-مشكلة الVirtual .. هي في زيادة حجم الملف ... فقط .

3- مشكلة الData Alignment.. لاتحدث اذا كان الكلاس هو واحد اثناء القراءة والكتابة ..

يعني لو عندنا كلاس

class Student
{
int i;
short int s;
double x;
};
و
class Student2
{
short s;
int i;
double x;
};

صحيح أن الكلاسين لهما نفس البيانات .. لكن من الخطأ ان نكتب Student و نقرأ Student2 ... عشان ماندخل بالمشاكل التي ذكرها الاخ خالد في موضوعه ... يعني اللي يعمل كذا هو الذي يتحمل الخطأ .. اما اذا كتبنا Student وقرأنا Student .. فلايوجد أي تأثير للData Alignmentفي المخرجات ... كلامي صحيح ؟؟؟؟؟ .

تم تعديل هذه المشاركة بواسطة الشمري في 13 فبراير 2008 في 09:48

logo1.png تطبيق طمأنينة ، نسخة بيتا على أندرويد

عبدالله الشمّري - Al-Shammari

CodingAlone.com

twitter @abshammeri

abshammeri AT gmail.com

github : abshammeri

هذا الموضوع مغلق.

مواضيع مشابهة